Meta強化影音理解引擎!Ego-Video框架讓AI能解析第一人稱影片內容
📋 重點摘要
●
Meta推出Ego-Video框架,讓AI能理解第一人稱視角影片內容。
●
Ego-Video透過專門的時間與視角建模,解決動態不穩定影片的解析難題。
●
此技術著重於理解影片內容,而非生成畫面,可應用於智慧助理、AR裝置等。
●
對企業而言,影音資料將可被解析利用,提升零售、教育與訓練等領域效率。
●
影音AI正從生成導向轉向理解與應用,未來平台價值將體現在資訊處理與決策支援。
【記者蔡富丞/柯妮妮 綜合報導】另一項近期受到關注的發展,來自Meta在影音理解領域的最新框架Ego-Video,主打讓AI能理解「第一人稱視角」影片內容。
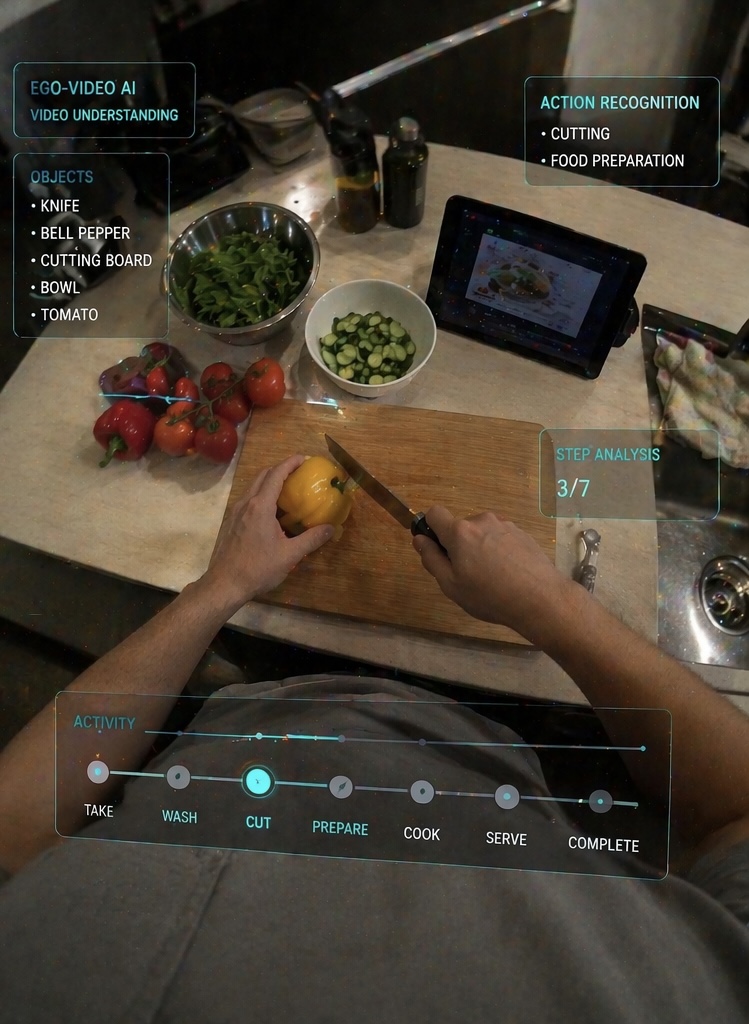
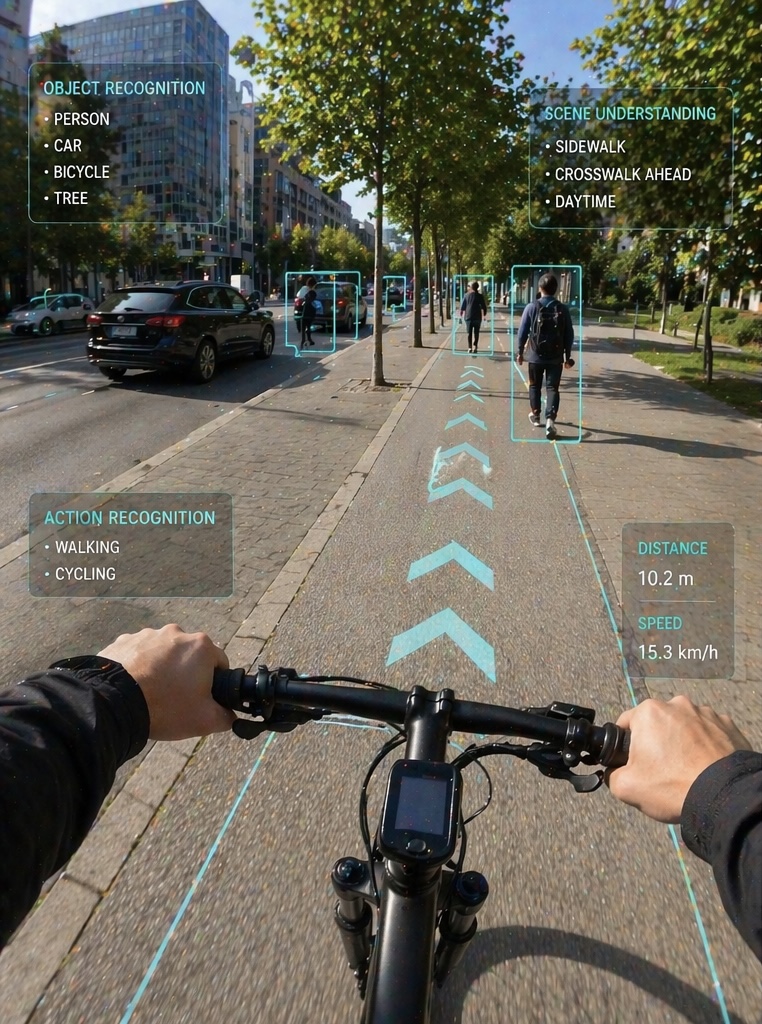
這類影片(如穿戴式裝置或日常紀錄)具有高度動態與不穩定視角,過去模型難以準確解析。Ego-Video則透過專門設計的時間與視角建模方式,使AI能辨識使用者行為、互動與環境變化。
這項技術的重點,不在生成畫面,而在「理解影片正在發生什麼」。系統可分析動作流程、物件互動與情境變化,進一步應用於智慧助理、AR裝置與內容整理等場景。
對企業而言,這代表影音資料不再只是被觀看,而是可被解析與利用。例如零售、教育與訓練領域,都能透過此類技術提升效率。
可以觀察到,影音AI正從生成導向,逐步擴展至理解與應用層。當模型能真正理解影像內容,未來平台價值將不只是創作,而是資訊處理與決策支援能力。
相關人物:
Mark Zuckerberg
相關組織:
Meta
🤔 讀到一半,先表個態?
🎯 搶頭香!這篇你的反應?