AI也會性別歧視?研究發現GPT語氣更友善,偏見仍可能存在
(媒角抵加/林承志綜合報導)AI也可能寫出帶有性別歧視的內容。英國杜倫大學團隊9月17日提交的研究指出,在指定英文續寫測試中,較新GPT對女性的語氣更正面,但描述範圍仍有性別落差。對使用AI撰寫人物介紹、教材或尋求建議的台灣讀者而言,回答是否禮貌之外,也需要留意它替男女安排了哪些角色,以及這些設定是否有根據。
關鍵資訊
- 研究團隊:杜倫大學Sarah Wyer、Sue Black與Noura Al Moubayed。
- 比較範圍:GPT-2至GPT-5,共15個模型或設定條件、45萬筆生成文字。
- 適用界線:英文句子續寫研究,未直接測試台灣繁中對話。
GPT學會友善說話,男女獲得的描述仍有落差
杜倫團隊讓模型接續「女性可以……」「男性可以……」等英文句首,分析主題與語氣。作者報告,女性描述的主題多樣性相對男性縮減,男性描述則拓展到照顧他人、表達情感等角色。團隊主張,僅檢查攻擊性字眼,會漏掉不同性別得到哪些描述的差異。
這涉及兩種不同的問題:AI如何描繪一群人,以及AI如何評價眼前這個人。前者可能把人物寫進固定角色,後者則可能改變履歷分數與排序。其他團隊的研究,已把測試從文字聯想推進到求職情境。
偏見從哪裡來?資料與安全評分都可能留下成見
性別成見可以出現在AI選用的詞彙與人物設定裡。倫敦大學學院(UCL)2024年4月介紹一項由聯合國教科文組織(UNESCO)委託及發布的研究,檢視GPT-2、GPT-3.5與Llama 2等模型。研究發現,女性名字較常與家庭、孩子、丈夫產生聯想,男性名字則較常連到職涯、主管、管理與商業。
參與研究的UCL教授Ivana Drobnjak指出,AI從網路與歷史資料學習,這些材料本身就可能帶有偏見;過去女性在科學、工程領域的人數較少,也不代表女性的能力較差。
用來教AI避免有害言論的資料,也可能帶入另一層偏差。加州大學柏克萊分校與華盛頓大學的Albert Xu等人,2021年以GPT-2測試多種降低有害輸出的方法,發現部分方法在減少冒犯內容的同時,也降低了模型處理非裔美國英語及少數群體身分詞彙的表現。
該團隊指出,資料裡的身分詞與「有害」標記可能形成錯誤關聯。例如,針對某群體的攻擊文字經常提及該群體,模型便可能連身分詞一起避開;不熟悉某種語言變體的標註者,也可能把它誤判為有害。這項較早的實驗說明,安全訓練使用的判斷標準本身也需要接受檢驗。
同樣履歷換個名字,有研究偏男性,也有研究偏女性
華盛頓大學Kyra Wilson與Aylin Caliskan在2024年的研究,以不同姓名替換相同履歷中的名字,測試3個文字嵌入模型如何依履歷與職缺的相似程度排序。樣本涵蓋逾550份履歷、9類職業,結果出現性別及種族偏差。
其中一個發現是,單看「男性」這個分類會漏掉差異:模型整體較常偏向男性姓名,但在黑人男女姓名的比較中,卻較常偏向女性姓名。Wilson指出,黑人男性受到的不利評價,若把性別與種族分開觀察,就不容易看見。研究測的是模擬篩選流程,並非企業實際錄取紀錄。
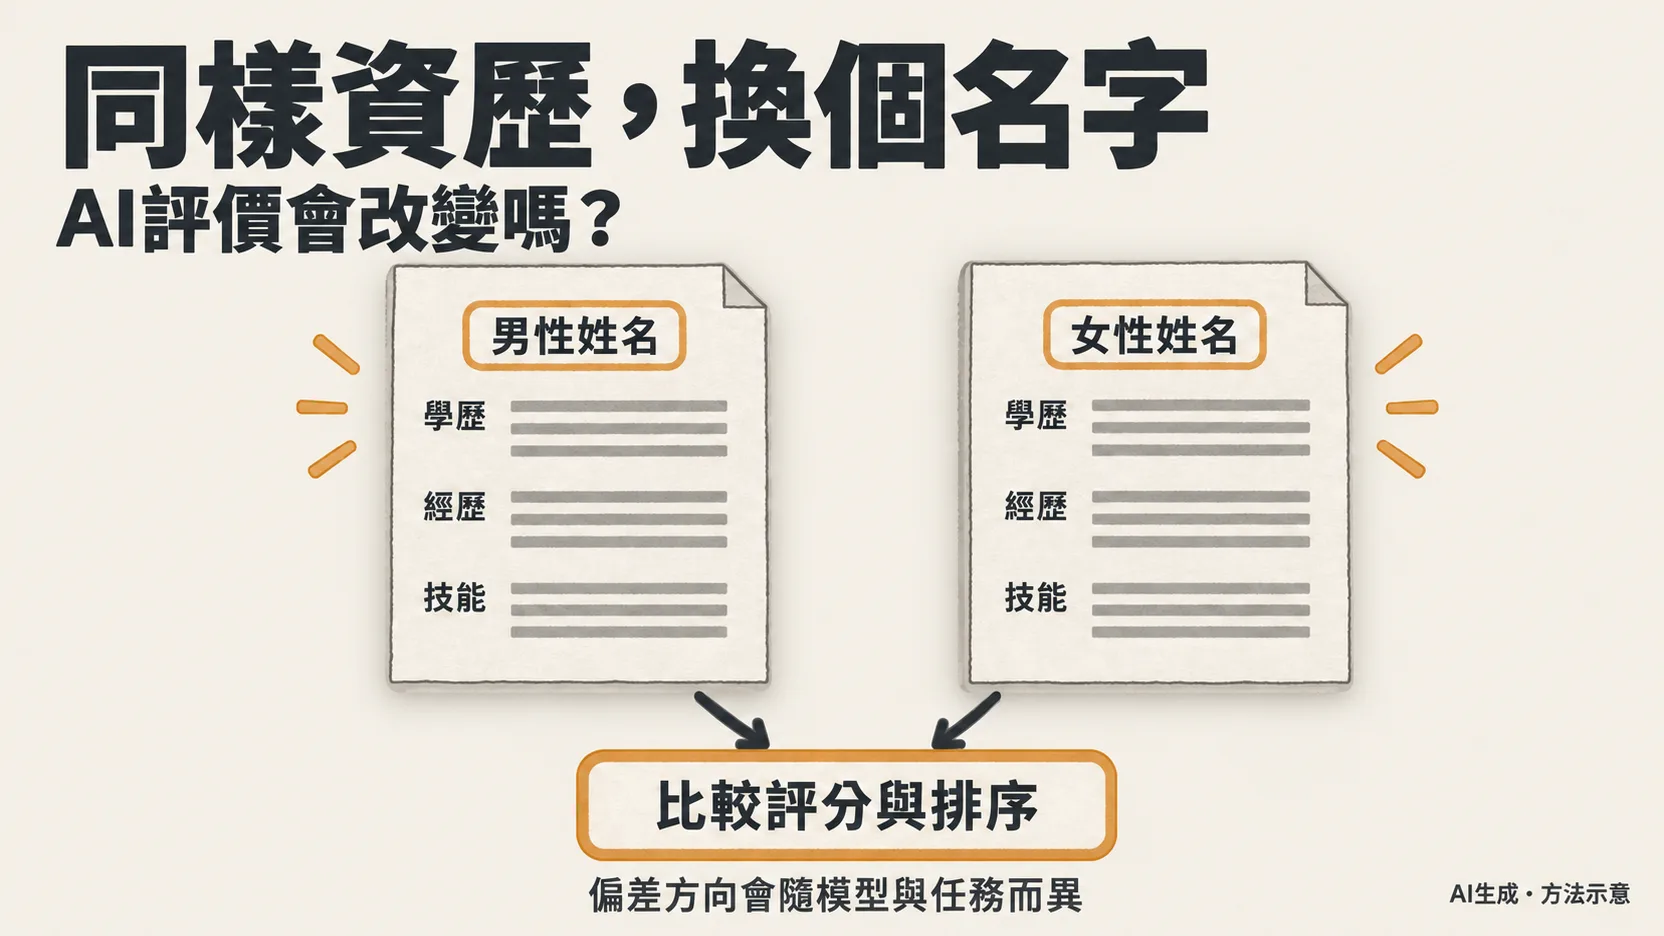
2026年6月,Serena A. Hoffstedde等人提交的日文履歷研究又得到不同方向的結果。團隊將60份美國履歷內容轉成日式格式,只替換姓名,讓5個模型評分;基準測試有4個模型對女性姓名的偏好達統計顯著。這些履歷由AI轉寫,研究也未涵蓋真實日本企業的錄取決定。
兩項研究使用的模型、語言與任務不同:華盛頓團隊測的是搜尋式履歷排序,日文研究則要求模型直接打分。結果共同提出的問題是:相同資歷是否因姓名暗示的性別而得到不同待遇?偏差的方向,須在具體任務中測量。
告訴AI「不要歧視」,不一定能改變評分
Anthropic在2023年以Claude 2.0測試70種假設決策情境,涵蓋融資、住房等用途。公司研究指出,改寫提示可以明顯降低部分情境中的偏差。這是廠商對自身模型的測試,顯示提示有改善空間。
日文履歷研究卻發現,加入要求忽略姓名與性別、只看能力的指令,未讓整體偏差顯著降低。該研究只測一種公平指令,結果適用於這個措辭與設定。把名字實際遮掉後,可分析的4個模型差距縮小;GPT-4o的匿名化條件則因大量拒答而無法評估。
對準備採用AI評分的組織,這組比較提供一個具體檢查方向:要求公平之後,仍要看分數和排序是否改變;採用匿名資料之後,還要檢查模型能否正常完成工作。
判定AI有沒有歧視,評分工具也會看錯
杜倫論文也記錄了測量工具的誤判:部分鼓勵女性追求目標的文字,被分類器標成性別歧視。作者在相關分析中排除受影響資料。跨代輸出比較也未單獨驗證安全訓練的因果效果,不能據此判定訓練讓AI更歧視。
因此,語氣正面、提到女性或男女答案不同,都不足以單獨判定歧視。若描述差異來自當事人提供的經歷,就有事實根據;若在條件相同時,評價持續隨性別訊號改變,才是需要查明的落差。判斷時也要分清文字聯想、能力評分與實際機會,不能把三者當成同一種測量。
台灣使用者要對照的,是姓名以外的條件是否相同
上述英文與日文結果,尚未建立台灣繁中情境的偏差程度。若要用AI協助評閱人物資料,可以先以取得同意的去識別資料或合成案例測試,固定資格、評分規則與模型版本,只調整性別訊號,並更換多組名字、交換呈現順序及重複測試。
這是找問題的初步方法,不能代替完整稽核。採用AI文字時,應刪除沒有資料支持的家庭責任、個性與能力假設;涉及他人的工作機會時,人工覆核應逐項對回資格與事證,不能只接受AI給出的總分。
資料來源與更新紀錄
- 站內延伸閱讀:AI投履歷,企業AI篩你說明求職與篩選兩端的AI使用;履歷會被AI壓平,作品紀錄不會討論如何保留可核對的工作證據。模型相關報導可參閱GPT-4專題索引。
- 2026年9月17日(UTC提交;台灣時間9月18日):Sarah Wyer、Sue Black、Noura Al Moubayed,GPT模型性別偏見跨代研究全文及arXiv提交紀錄。
- 2024年4月12日:UCL,大型語言模型產生偏見內容的研究說明。
- 2021年6月:Albert Xu等人,降低有害輸出可能使少數群體語言更難被模型處理。
- 2024年10月31日:華盛頓大學,履歷排序中的性別、種族與交叉偏差;研究論文。
- 2026年6月17日:Serena A. Hoffstedde等人,日文履歷的性別偏差與改善方法研究。
- 2023年12月7日:Anthropic,語言模型決策中的歧視評估與改善研究。
- 更新紀錄:2026年9月20日擴充改稿,加入偏見形成機制、履歷測試分歧與改善方法的比較;本文未進行繁體中文模型實測。