HugAgent公開訪談評測,AI預測個人看法變化仍有落差
AI能否準確預測個人看法在不同情境下的變化?
麻省理工學院等機構的研究團隊釋出的HugAgent訪談評測資料顯示,AI模型在預測個人看法變化方面仍有落差。研究以54人的資料進行測試,發現模型較能還原既有看法,但在預測當個人面對新情境時看法如何改變,預測得分為68.61%,遠低於真人重測的85.66%。這顯示AI在跨情境推理與掌握個人看法變化方面,仍是待改善的能力。
(媒角抵加/林承志綜合報導)麻省理工學院(MIT)等機構研究團隊在HugAgent2026年10月8日的公開更新釋出訪談評測資料與程式,測試AI能否根據一個人的回答,預測他在新情境下怎麼想。研究採54人的資料,發現模型較能還原既有看法,預測看法變化仍落後真人重測。台灣團隊可參考訪談與評測流程,資料使用另有非商業及禁止個人側寫條款。
關鍵資訊
- 研究工具:HugAgent評測個人看法與變化;Trace Your Thinking提供AI訪談框架。
- 資料規模:54人、1,742項評測,涵蓋醫療制度、公共監視器與住宅增密議題。
- 核對方式:將AI預測與受訪者本人的問卷回答比較,另以真人隔兩週重答作為基準。
- 使用條件:評測程式採MIT授權;真人資料採CC BY-NC 4.0,下載另有條款確認。
先問本人怎麼想,再讓AI回答新情境
HugAgent公開程式庫的10月8日更新包含評測資料、評分程式與結果欄位。這套工具把訪談模擬拆成兩個問題:AI能否還原一個人的既有看法,以及條件改變後,AI能否預測這個人會怎麼回答。
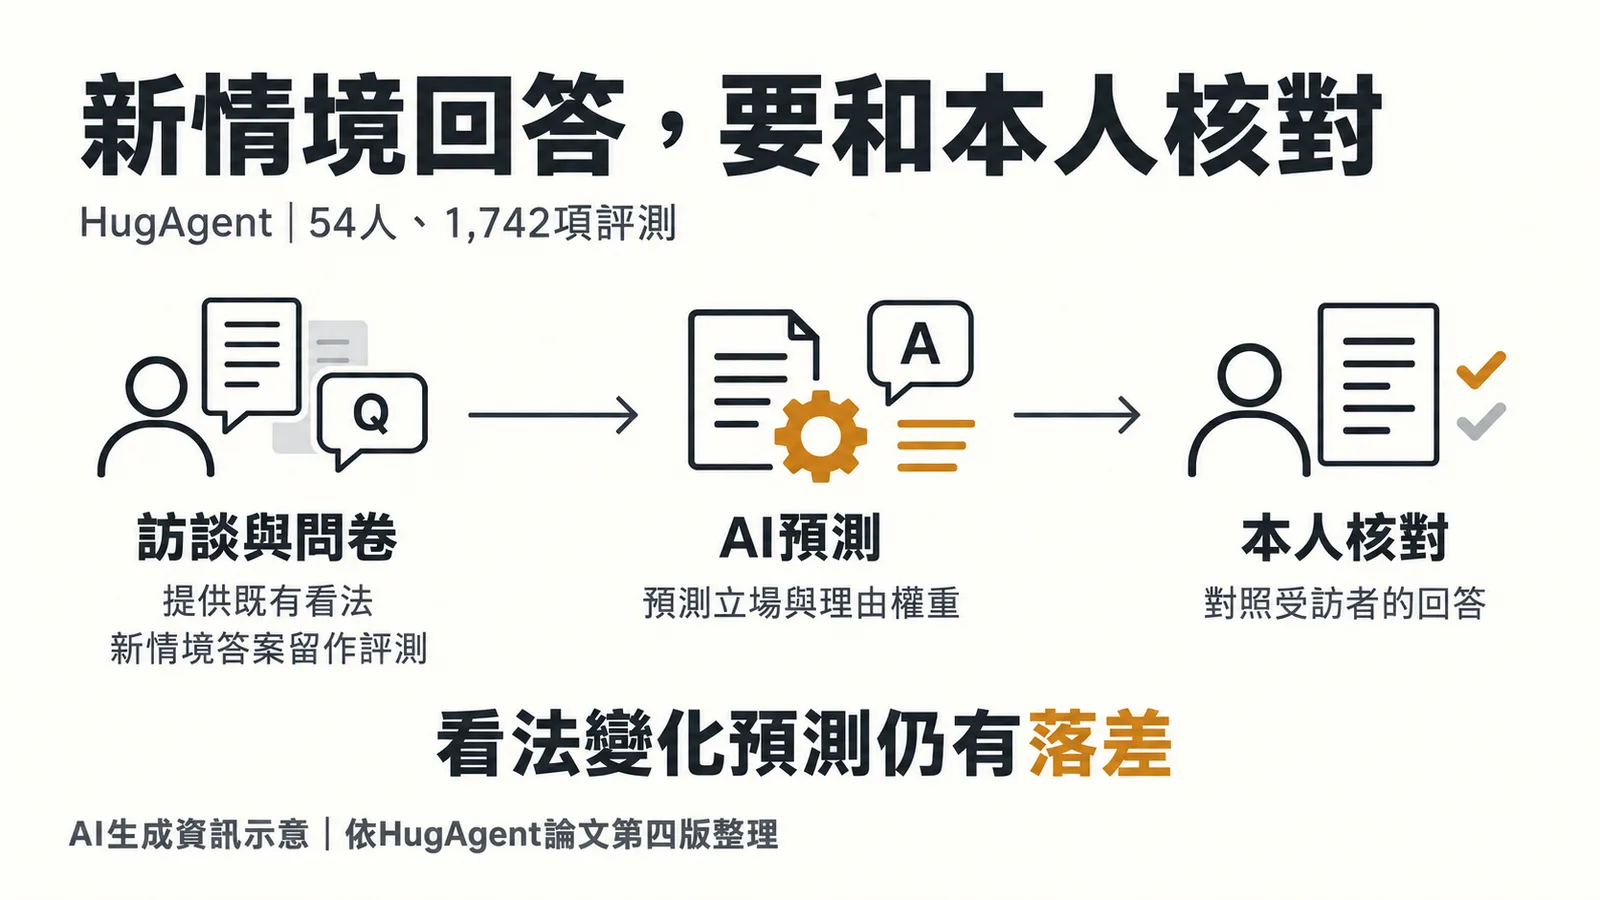
研究團隊在8月31日更新的論文第四版說明,受訪者先填寫問卷,交代立場、理由的重要程度與不同情境下的回答,再進行8至20組問答的AI訪談。訪談會追問理由與背景;用來核對預測的新情境問卷答案,則留在評測端。
品質篩選後留下54人的資料。團隊建立356項既有看法推斷題,以及1,386項看法變化預測題。前者要求模型從其他回答推斷某項因素的正負影響;後者要求模型預測新條件下的立場與理由權重。
看法變化得分,仍低於本人重答的一致性
依論文結果表,Claude Sonnet 4.5在看法變化預測的平均得分為68.61%,真人重測基準為85.66%,相差17.05個百分點。模型成績取三個議題、五次執行的平均;真人基準來自隔14天重答、通過資料一致性篩選的13人。
這項得分採容許誤差計算:五點量尺的預測與本人答案相差不超過1點、十點量尺相差不超過2點,就算答對。評測核對的是本人自陳的立場與理由權重,研究樣本與議題範圍也限定了結果的適用條件。
換了議題,AI更難沿用同一人的訪談
同一個人的訪談內容,也未必能支撐另一個議題的預測。論文跨議題測試中,GPT-4o的看法變化預測得分,從同議題的63.11%降至跨議題平均44.64%。例如,模型讀到的是某人在一個公共政策議題上的回答,評測卻要求它推測此人在另一議題的新情境立場。
研究團隊另測試增加訪談問答量;在看法變化預測上,成績沒有呈現穩定提升。作者認為,模型較依賴訪談中的議題線索,跨情境推理與掌握個人看法如何改變,仍是待改善的能力。
訪談模擬已有其他研究。史丹佛HAI在2025年5月的政策簡報介紹,以1,052人的兩小時訪談建立AI模擬,再拿本人的問卷與實驗回答核對;簡報也提出個人資料、受訪同意與模擬使用的監督問題。
台灣團隊試用,先讓本人核對新情境答案
HugAgent的資料釋出說明將程式與真人資料分開處理:程式採MIT授權,資料採CC BY-NC 4.0;Hugging Face下載另要求接受條款及禁止個人側寫用途。文件也將資料定位為評測用途,排除訓練與微調;完整原始訪談及招募紀錄仍保留為非公開資料。
配套的Trace Your Thinking訪談框架可用AI追問,將回答整理成可查看、修改的逐字稿與想法關聯圖。它是自架軟體,需要部署環境、MongoDB資料庫與模型服務帳號;語音功能另需相關API帳號及麥克風。台灣團隊的門檻在於部署、模型服務及訪談資料管理。
媒角抵加建議,研究或使用者訪談團隊可先取得同意,以自建的繁體中文訪談做小型測試:留下幾個新情境,分別讓AI與本人回答,再核對差距;AI整理出的理由與關聯,也交由本人確認。涉及個人資料的試用,可一併參考AI面試紀錄與資料用途及AI代理的資料權限與紀錄管理。更多部署與測試案例,見AI工作流程。
資料來源與更新紀錄
- HugAgent公開更新紀錄:2026年10月8日,公開評測資料、評分程式與結果欄位。
- HugAgent研究論文第四版:2026年8月31日更新,提供方法、樣本、容許誤差與比較結果。
- HugAgent程式庫與資料釋出說明:資料範圍、授權與下載條件。
- Trace Your Thinking程式庫:訪談框架、部署與語音功能需求。
- 史丹佛HAI:Simulating Human Behavior with AI Agents:2025年5月20日,另一項訪談模擬研究的政策簡報。
- 更新紀錄:2026年10月12日,整理公開文件與論文版本,核對評測數量、計分方式及使用條件。
HugAgent的評測方法是什麼?
評測方法是先讓受訪者填寫問卷,交代立場與理由,再進行AI訪談。接著,AI會根據訪談內容預測受訪者在新情境下的回答,並將預測結果與受訪者本人的問卷回答進行比較,同時也以真人隔兩週重答作為基準。
AI預測個人看法變化的準確度有多高?
根據研究,AI模型在預測看法變化上的平均得分為68.61%,而真人重測的基準為85.66%,兩者相差17.05個百分點。此外,當AI需要跨議題進行預測時,準確度會進一步下降。
HugAgent的資料使用有哪些限制?
評測程式採用MIT授權,但真人資料則採CC BY-NC 4.0授權,下載時需另行確認條款,並禁止個人側寫用途。資料僅限評測用途,不得用於訓練或微調模型。