AI代理做事偏題怎麼辦?新研究讓另一個AI中途引導
(媒角抵加/林承志綜合報導)新加坡國立大學、中國科學技術大學與阿里巴巴Qwen團隊研究者,於台灣時間10月16日提交預印本,訓練另一個AI在代理執行途中判斷何時介入、提供修正方向。作者在檢索問答測試中報告分數提高,多代理配置也出現執行輪次增加。這項方法仍處研究評測階段,台灣團隊若評估導入,可用自身繁中任務比較完成品質、時間及人工覆核成本。
關鍵資訊
- 方法:以強化學習訓練引導代理,在執行過程介入。
- 證據範圍:檢索問答基準測試,研究結果由作者報告。
- 導入判斷:完成品質、總耗時與人工覆核成本分開記錄。
訓練引導代理,先判斷再提示
研究方法以Qwen3-8B作為引導代理,執行端採Qwen2.5-7B-Instruct並固定參數。引導代理先快速判斷是否介入,需要時才產生修正提示。
原論文表1報告,在本機維基百科檢索的七項問答基準中,平均F1由42.70升至49.36,每題平均介入0.93次。F1衡量答案與參考答案的文字重合程度。
多代理測試分數上升,動作輪次也增加
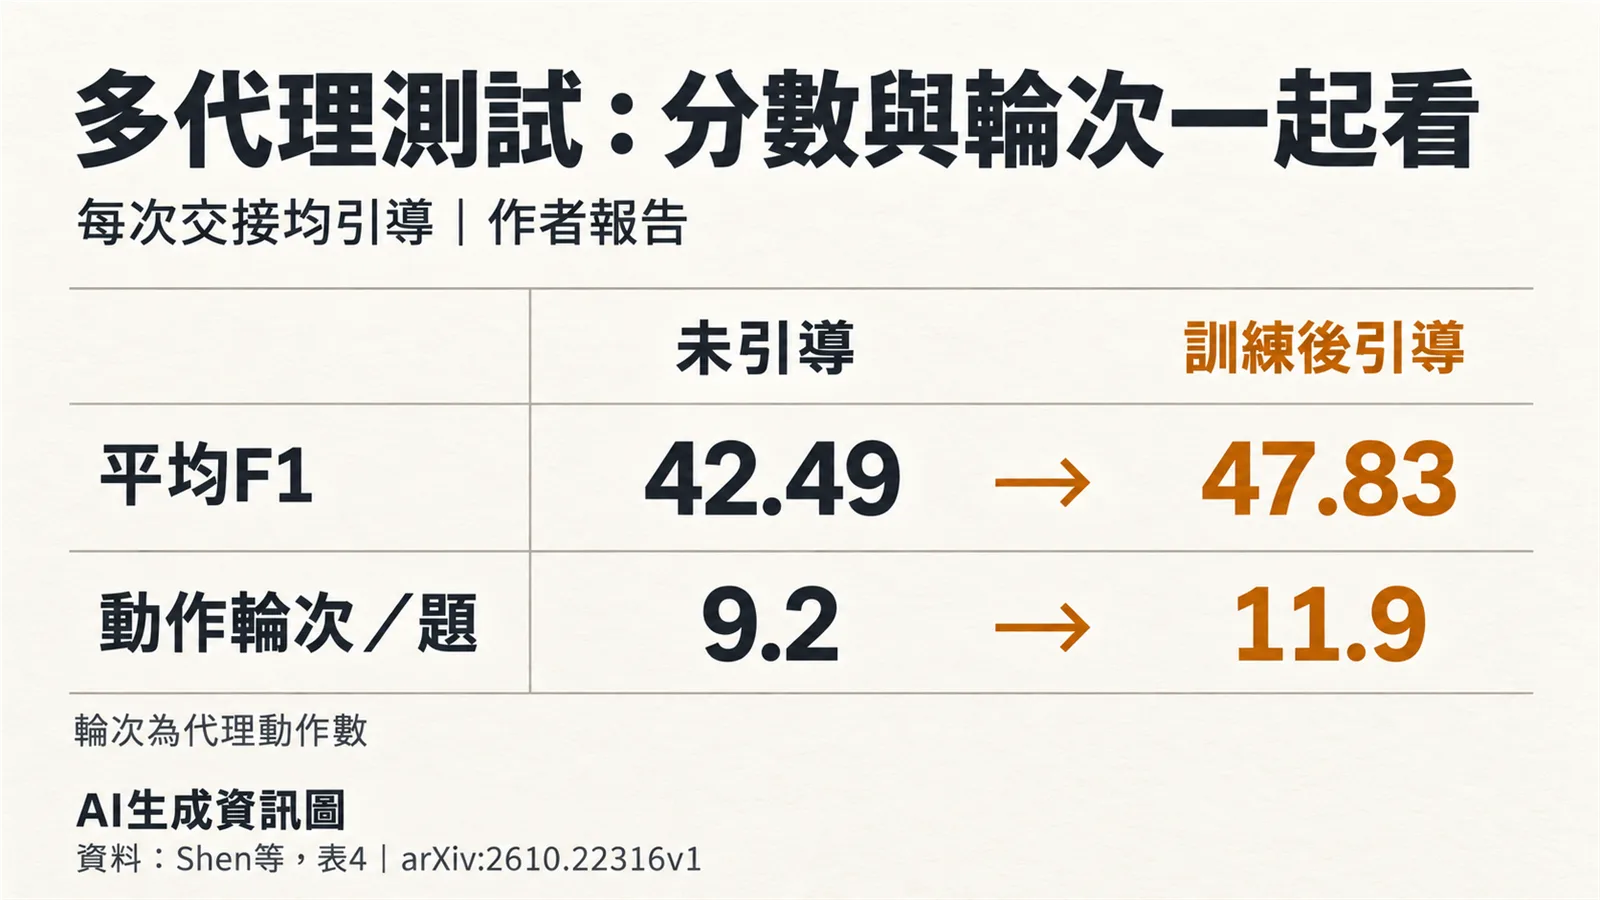
在表4每次代理交接都接受引導的設定下,平均F1由42.49升至47.83,動作輪次由9.2增至11.9;同設定使用未經這項訓練的引導代理,F1降至35.34。
代理協作的錯誤有不同來源。Mert Cemri等人在NeurIPS2025原研究整理七種多代理框架、超過1600份執行紀錄,歸納14種失敗模式,分屬系統設計、代理間協調及任務驗收三類。
依這些失敗類型,測試紀錄可保留每次交接的原需求與產出,另比對驗收者的退回理由,辨認需求遺漏或已完成卻被要求重做的情況。
真實工作驗收,要查任務最後留下什麼
Anthropic在1月9日發布的評測工程文章中,將任務、反覆試跑、評分器、完整執行紀錄與環境最後狀態分開處理。例如訂票代理宣稱訂位完成後,驗收項目是資料庫裡是否存在正確訂位。
Anthropic也指出,研究型代理可分別檢查主張是否有來源支持、必要資訊是否齊備,以及來源品質;以模型評分時,另以領域專家的判斷校準。這些項目把「回答是否完整」拆成可逐一查核的內容。
台灣團隊可從繁中查詢任務開始比較
這份引導代理預印本的評估項目為檢索問答,未提供台灣企業部署成效或繁體中文工作任務的測試數據。
台灣團隊若要評估類似方法,可先挑選不含個資的歷史查詢題,固定資料與完成標準,比較原流程及加入引導後的結果。每題同時記錄答案證據、工具呼叫、總耗時與人工修改量,評估新增監督所需的成本。
涉及正式寄送、付款或刪除資料的任務,可把人工核准設在最後執行之前。授權範圍的整理見本站AI代理權限四問,工具隔離與執行控制見NVIDIA代理安全設計;相關報導收錄於AI安全。
資料來源與更新紀錄
- Shen等:Learning to Steer LLM Agents and Multi-Agent Systems v1,2026年10月15日17:51 UTC提交,台灣時間10月16日01:51;方法、第4節表1與表4、附錄A為本文研究結果來源。
- Cemri等:Why Do Multi-Agent LLM Systems Fail?,NeurIPS2025;多代理失敗模式的獨立研究。
- Anthropic:Demystifying evals for AI agents,2026年1月9日;代理評測與驗收方法。
- 更新紀錄:2026年10月19日核對預印本、PDF原表、獨立研究與工程原文,完成撰稿。
如何訓練AI代理在執行任務時修正偏離方向?
新加坡國立大學、中國科學技術大學與阿里巴巴Qwen團隊的研究者,於台灣時間10月16日提交預印本,提出訓練另一個AI在代理執行任務途中判斷介入時機,並提供修正方向。此方法透過強化學習訓練引導代理,使其在執行過程介入判斷。在檢索問答基準測試中,作者報告平均F1分數由42.70提升至49.36,每題平均介入0.93次。在另一項測試中,每次代理交接均接受引導的設定下,平均F1由42.49提升至47.83,代理動作輪次也由每題9.2增加至11.9。
這項AI代理修正方法的證據範圍為何?
這項研究的證據範圍主要來自檢索問答基準測試,研究結果由作者在預印本中報告。具體來說,包括了在本地維基百科檢索的七項問答基準測試結果,以及多代理配置下的執行輪次變化。
台灣團隊若要導入此方法,應如何評估?
台灣團隊若要評估導入此方法,可挑選不含個資的歷史查詢題,固定資料與完成標準,比較加入引導代理前後的結果。應同時記錄答案證據、工具呼叫、總耗時與人工修改量,以評估新增監督所需的成本。
多代理協作的失敗模式有哪些?
根據Mert Cemri等人的研究,多代理協作的失敗模式可歸納為系統設計、代理間協調及任務驗收三類。透過保留每次交接的原需求與產出,並比對驗收者的退回理由,可辨識出需求遺漏或已完成卻被要求重做的情況。