AI代理反覆搜尋、任務做不完?R2S研究先修教師評分
(媒角抵加/林承志綜合報導)AI代理反覆搜尋、最後用完回合,可能與訓練時的教師評分有關。NVIDIA研究人員Shu Zhao與Tan Yu於台灣時間2026年10月21日提交R2S預印本,先調整教師模型,再訓練學生代理;作者在模擬購物測試提高完成率。研究已提供程式與模型,真實工作流程及繁體中文任務的改善仍未有測試結果。
關鍵資訊
- 研究與日期:R2S,論文於2026年10月20日UTC首次提交arXiv,台灣時間為10月21日;目前為預印本。
- 調整哪一步:教師接手與學生判斷分歧較大的任務狀態,用後續過程修正評分,再將評分能力教回教師模型。
- 作者報告成果:Qwen3.5-9B教導Qwen3.5-4B,在WebShop的500個標準測試目標中,成功率由一般蒸餾的34.6%升至55.9%。
- 使用門檻:研究程式與模型已公開;自行訓練涉及Linux、GPU、上游資料與可重播的任務環境,並由團隊核對完成條件。
- 成熟度與台灣:模擬環境研究階段;論文未提供台灣企業流程、繁中任務或完整成本效益的測試結果。
教師會做任務,逐字評分卻可能放過拖延
在這類訓練中,學生模型負責執行多步驟任務,教師模型則對學生產生的文字逐一提供機率分布,作為學習依據。這種讓學生在自己的行動過程中向教師學習的方式,英文稱為on-policy distillation(OPD)。
作者在R2S論文指出,教師模型接手某些任務時仍能做完;但只根據當下文字評分時,卻可能容忍「再看看」「再搜尋」這類延後行動的選擇。學生沿著這些選擇繼續操作,最後耗盡回合。作者把完整執行能力與局部評分之間的落差,稱為「執行—評分落差」。
R2S針對的是蒸餾流程中的這項評分問題。其他研究也嘗試在執行途中介入,例如讓另一個AI中途引導偏離任務的代理;R2S把調整時間提前到學生正式訓練之前。
讓教師接手八次,再把結果用回評分
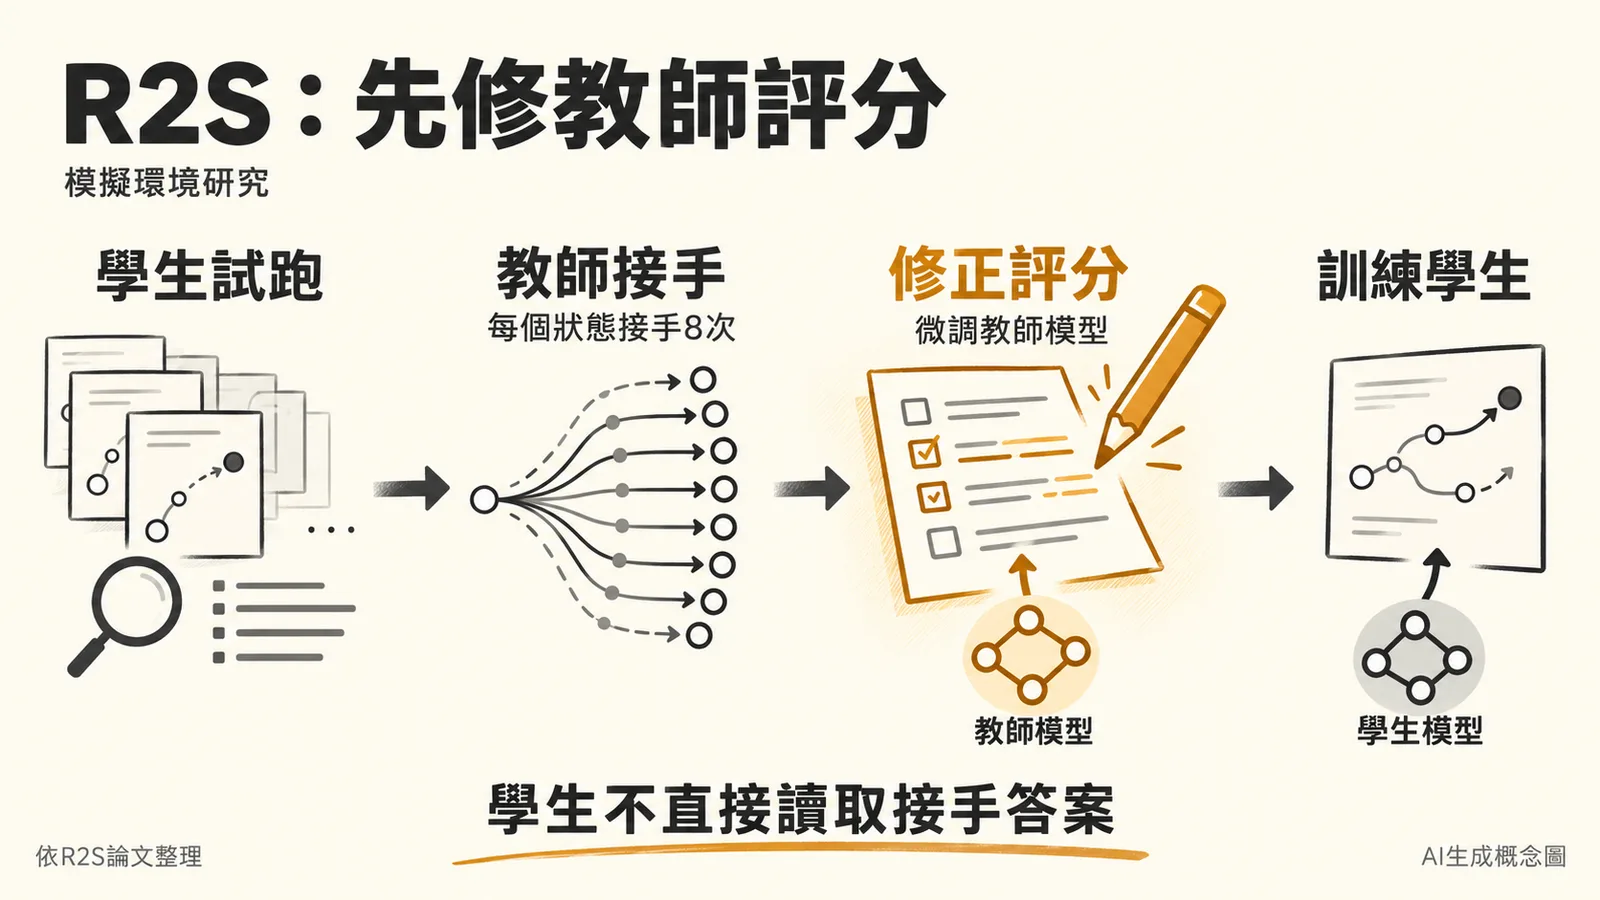
依論文的方法與附錄C,研究先讓尚未訓練的學生執行任務,挑出學生與教師判斷分歧較大的狀態,再讓教師從同一狀態接手八次。研究依接手過程的結尾是否一致,或模型評審的判斷進行篩選;在購物測試中,評審模型會核對選購商品是否符合指令。
接著,原教師參考選出的接手過程,重新評估學生從分歧位置到任務結束所產生的文字。研究團隊用這些評分微調一份教師模型副本,讓它日後即使沒有參考過程,也能給出較接近看過後續結果時的評分。
最後,調整過的教師被固定下來,負責一般OPD訓練。學生仍執行自己的任務過程,訓練時不會直接讀到教師的接手答案。這項方法的全名Rollout-to-Scorer Distillation,描述的就是將執行過程帶來的資訊,轉進評分模型。
模擬購物成功率由34.6%升至55.9%
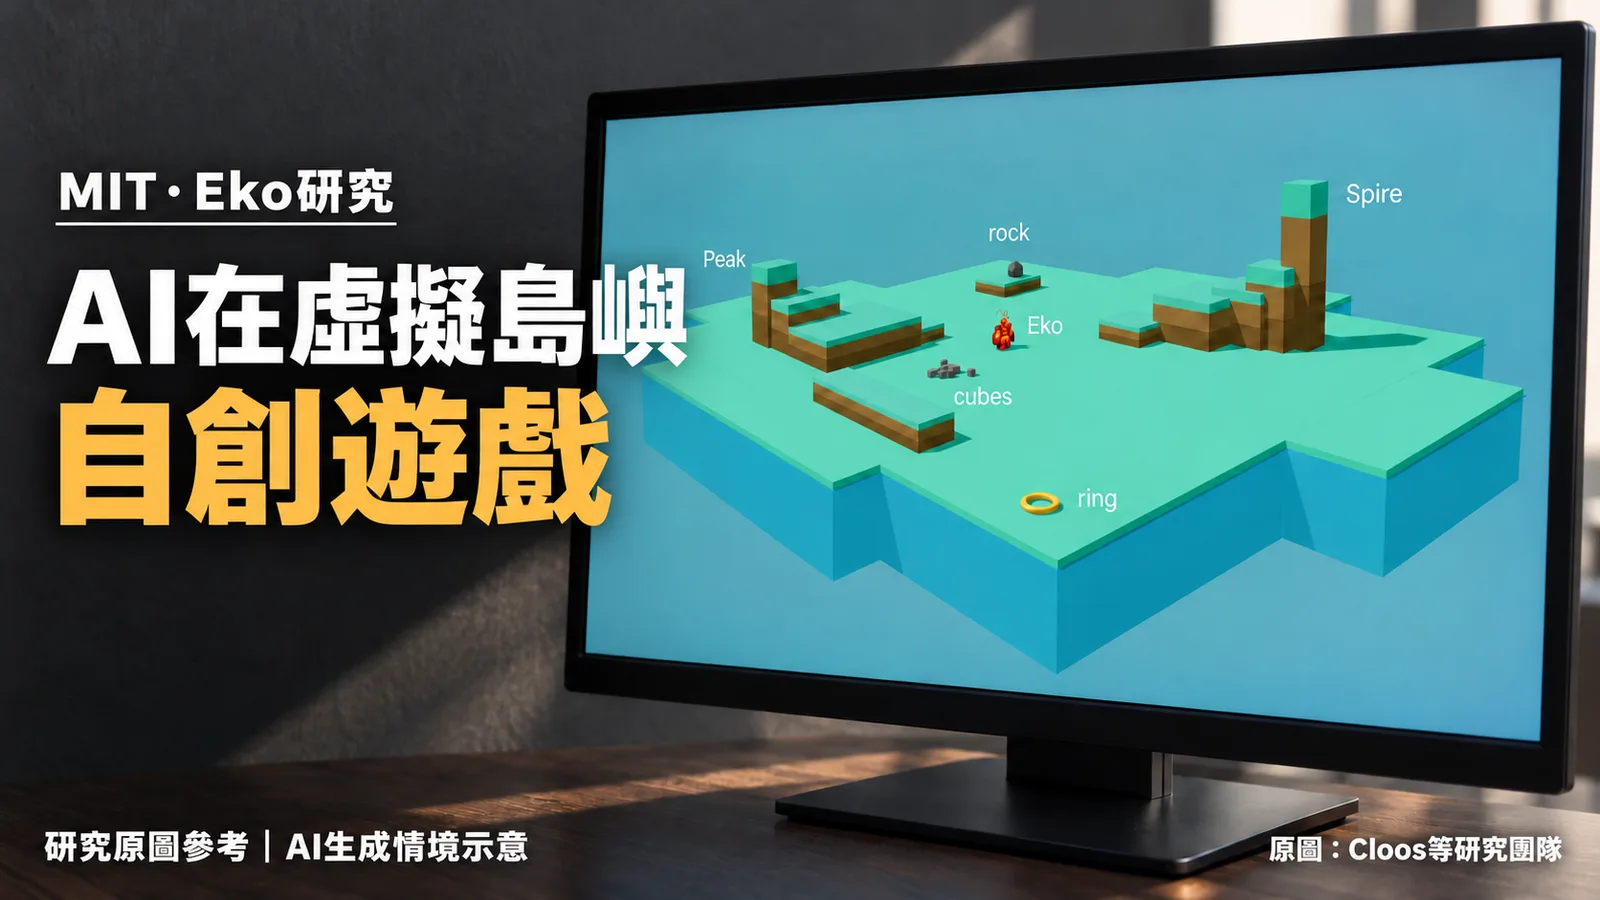
研究使用ALFWorld、WebShop與ScienceWorld三個環境。WebShop原開發團隊將它定義為模擬電商網站;ALFWorld包含文字互動環境,讓代理執行居家任務;Ai2對ScienceWorld的說明則是以文字指令在虛擬世界進行基礎科學實驗。R2S的測試採文字代理操作,沒有真實訂單、居家機器人或實驗室作業。
作者以兩個教師模型、四個學生模型組成12組「教師—學生—環境」設定。以Qwen3.5-9B教導Qwen3.5-4B為例,主表2列出的WebShop成功率,從一般OPD的34.6%升至R2S的55.9%,增加21.3個百分點;測試範圍是500個標準購物目標。
在同一組模型的ALFWorld已見環境測試集中,用完回合仍未完成的比例由34.3%降至19.5%。這項結果對應作者想處理的失敗方式:減少持續操作、卻遲遲沒有完成目標的情況。
主表每組設定只進行一次150步訓練,再以最終模型權重進行三次解碼評估;表中的誤差反映這三次評估的差異。作者另在一組教師與學生搭配上比較三次學生訓練,但共用同一個調整後的教師,訓練重複次數仍有限。
不用任務獎勵,仍多出教師接手與微調
論文以「不使用獎勵」描述R2S:主要流程不拿環境給的任務獎勵來修正教師或訓練學生,仍以共識、完成訊息或模型評審挑選接手過程。測試時則使用環境的完成結果計算成功率。
前處理每組設定最多挑選2,400個狀態,每個狀態接手八次,合計最多19,200次教師接手;此前還有學生試跑,此後還有教師微調。這些都是學生蒸餾之前增加的運算。論文沒有提供把完整流程納入後的成本效益比較,任務回合減少的結果尚未回答總訓練費用是否下降。
程式已公開,部分比較與測試資料仍待補齊
R2S程式釋出說明提供固定版本的訓練流程,Hugging Face集合列有24個修正後教師與學生模型檢查點。不過,程式說明明載ScienceWorld原實驗的測試題目順序未附在儲存庫;自行合成資料時,選出的134題會是不同子集,要對齊原表數字仍需原實驗的測試檔。
研究重現文件也說明,主表另外三種進階對照方法的程式仍留在作者私有分支。公開版本提供的重現流程,與完整重跑論文全部比較之間,還有資料與程式缺口。
台灣團隊先用可重播任務核對完成率
對台灣自建代理的團隊,R2S提供一條調整訓練的方法。公開訓練版本以Linux與多GPU環境運作,另需準備基礎模型、上游資料及可恢復狀態的模擬環境;論文的模型實驗集中在Qwen系列,沒有繁體中文任務或台灣企業流程的測試結果。
媒角抵加建議,準備採用這類AI工作流程訓練方法的團隊,先挑選可重播的內部測試任務,由人員訂明完成條件,並排比較原有與調整後模型的完成率、耗盡回合比例及總運算費用。涉及實際付款、寄信或修改正式資料的操作,可先放在測試環境,連同AI代理的權限與批准流程一起核對,再決定是否擴大使用。
資料來源與更新紀錄
- Shu Zhao、Tan Yu:R2S原始論文與提交紀錄:2026年10月20日17:40:08 UTC首次提交,台灣時間為10月21日01:40:08;本文採v1預印本。
- R2S論文全文:方法、主表2、回合耗盡分析及附錄C至E;成果為作者報告。
- R2S研究專頁、固定版本程式及重現文件:方法釋出、執行門檻及未包含項目。
- R2S模型集合、WebShop學生模型卡:24個檢查點清單及本文購物比較的模型、測試與解碼設定。
- WebShop原始專案、ALFWorld原始專案、Ai2:Evaluating agents for scientific discovery:各基準的模擬環境與任務背景;Ai2說明發布於2026年4月13日。
- 更新紀錄:2026年10月22日完成本文,依原論文及公開釋出文件整理。
AI 代理任務失敗與教師評分有何關聯?
NVIDIA 研究人員 Shu Zhao 與 Tan Yu 提出的 R2S(Rollout-to-Scorer Distillation)研究,發現 AI 代理在執行多步驟任務時反覆搜尋最終耗盡回合,可能與訓練時教師模型的評分機制有關。研究指出,教師模型在評分時可能容忍「再看看」或「再搜尋」等延後行動,導致學生模型沿著這些選擇操作,最終無法完成任務。為了解決此問題,R2S 方法先調整教師模型,讓其接手學生判斷分歧較大的任務狀態,並根據後續過程修正評分,再將修正後的評分能力教回教師模型,以提升學生代理的任務完成率。在模擬購物測試中,此方法成功率從 34.6% 提升至 55.9%。
R2S 研究如何修正教師模型的評分問題?
R2S 研究透過讓教師模型接手學生模型難以判斷的任務狀態,並觀察其完成過程。接著,利用這些觀察到的完整執行過程來重新評估學生模型在分歧點之後產生的文字,並據此微調教師模型,使其日後能給出更精確的評分,減少執行與評分之間的落差。
R2S 研究的程式與模型是否已公開?
是的,該研究已公開其程式與模型。然而,若要自行訓練,則需要具備 Linux 環境、GPU 資源,並能處理上游資料及可重現的任務環境,且需由團隊核對完成條件。
R2S 研究在台灣的真實工作流程或繁體中文任務上有測試結果嗎?
目前的研究仍處於模擬環境階段,論文並未提供在台灣企業真實工作流程或繁體中文任務上的測試結果,也未有完整的成本效益分析。