AI遇到怪現象會追問嗎?LongChang測試模型能否找出隱藏規則
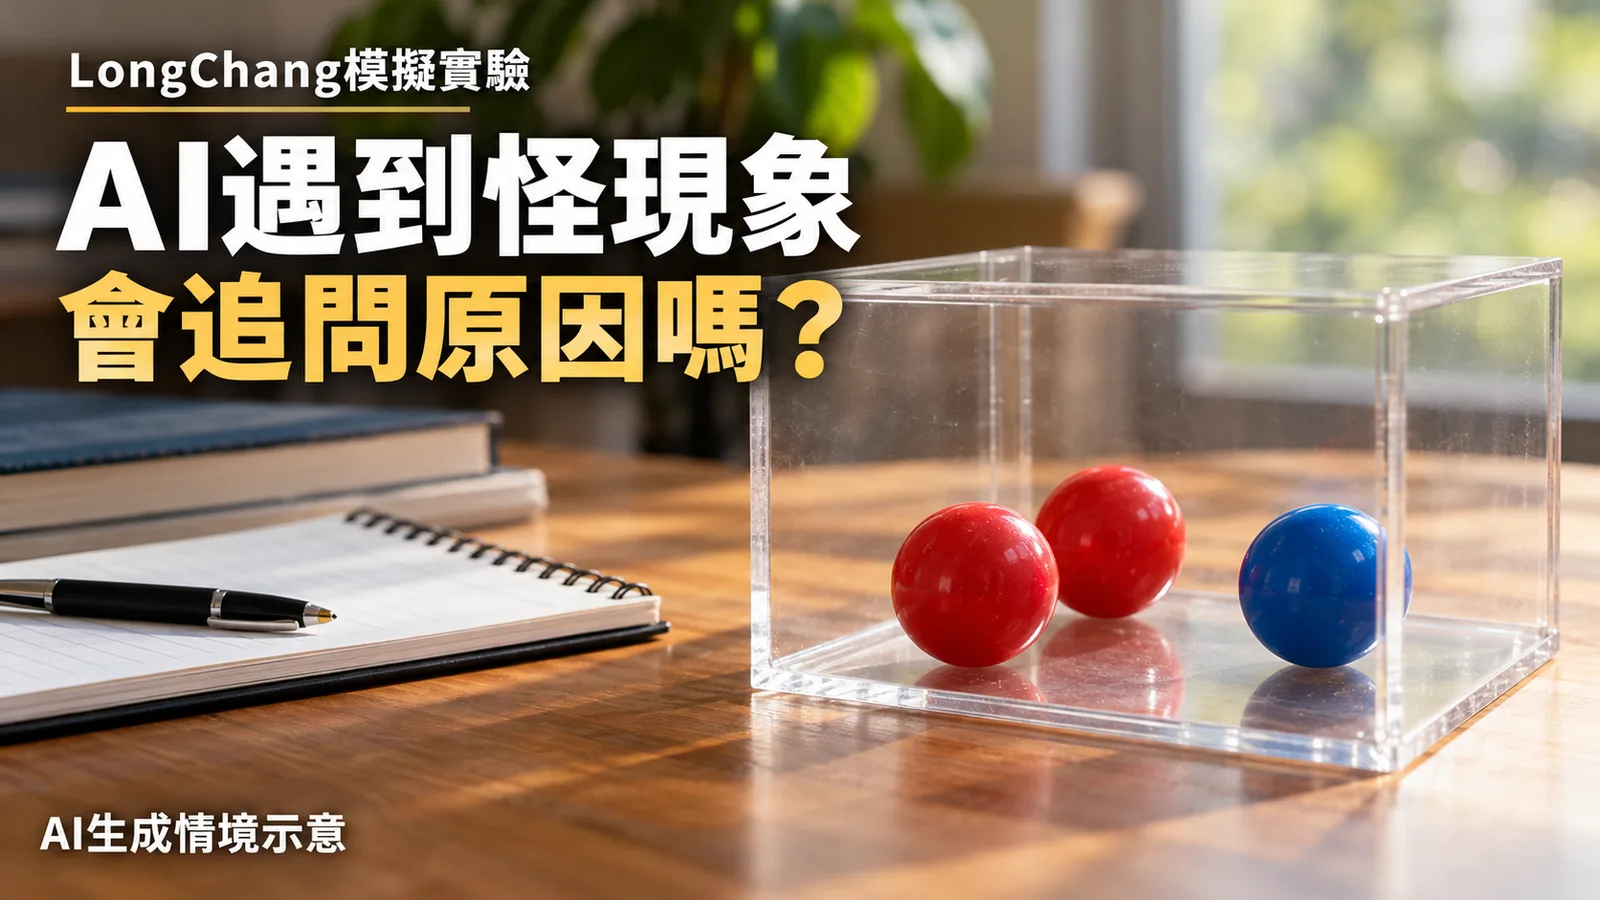
(媒角抵加/林承志綜合報導)紅球撞藍球後變色,AI會追問原因,還是照原計畫繼續?香港科技大學(廣州)等機構研究團隊提出LongChang評測,讓語言模型在改寫物理規則的模擬房間自由探索。預印本於台灣時間10月28日提交arXiv,12個受測模型中,只有GPT-6-Astra在作者設定的評分下取得16.7%發現率;測試答案是事先寫入環境的規則。
關鍵資訊
- 測什麼:模型能否自行發現異常、提出問題,再用實驗找出模擬世界的規則。
- 如何算成功:解釋符合隱藏規則,且探索紀錄有足夠實驗支持,兩項同時通過。
- 公開材料:作者提供網頁示意與540筆主測試紀錄;GitHub目前缺完整執行程式,結果由AI評分。
同色球再相撞,才分出兩種解釋
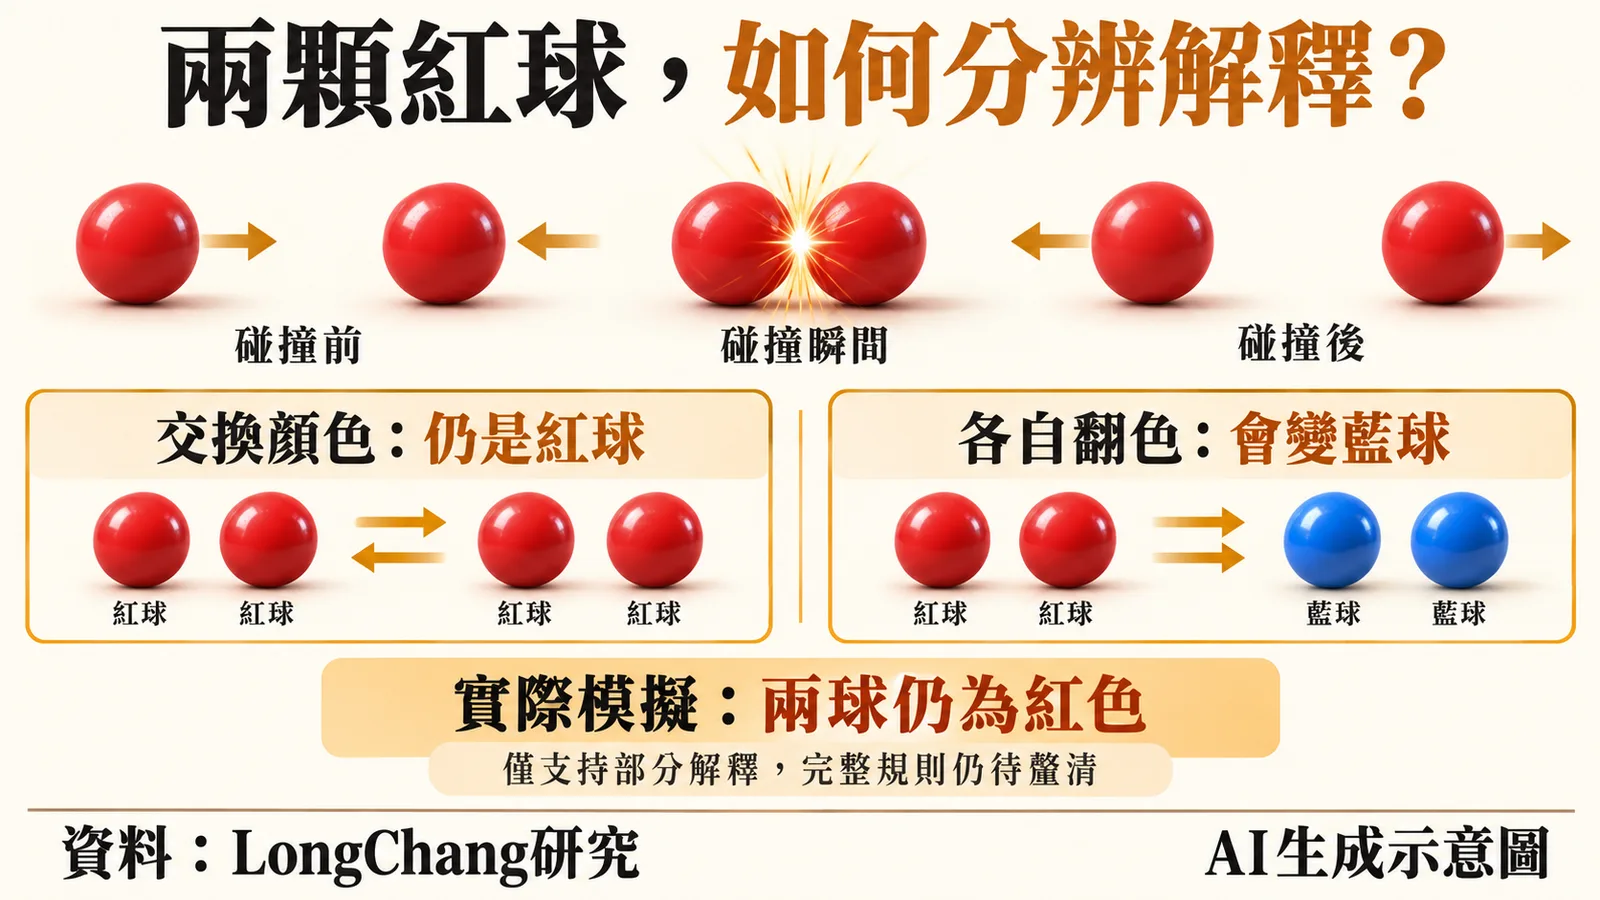
在作者公開的碰撞案例中,一顆紅球撞上一顆藍球,兩球顏色改變;再撞一次,顏色又恢復。這至少符合兩種解釋:兩球互相交換顏色,或每顆球各自從紅變藍、從藍變紅。重複同一組紅藍碰撞,兩種解釋都說得通。
GPT-6-Astra換了一個測試:讓兩顆紅球相撞。若是交換顏色,兩顆仍會是紅色;若是各自翻色,兩顆就會變藍。模擬結果是兩顆都維持紅色,支持交換顏色的解釋。
不過,公開評分紀錄顯示,這個場景的3次測試都只有實驗支持一項過關。評分還要求交代交換何時觸發、適用哪些物件,完整規則仍未辨識成功。
15個模擬場景,考模型自己找問題
LongChang論文全文說明,團隊以MuJoCo物理模擬器建立15個基礎場景:1個保留一般物理作對照,其餘14個各改寫1條規則,例如讓質量影響下落速度,或讓接觸改變球的顏色。研究者知道答案,探索模型則不會收到規則或指定研究題目。
模型取得的是物件位置、運動狀態與儀器讀數等文字資訊,可以推球、拋球、拿起或放下物件,也可以等待觀察,並設計裝置。每次行動都留下紀錄,最後的解釋要指出哪些回合提供支持。
這項設計把「要查什麼」也交給模型決定。任務不只要求答出公式,還要注意異常、改變原本的調查方向,再選擇能分辨不同原因的動作。整個實驗發生在程式設定的世界中。
16.7%同時要求說對規則、拿出證據
依作者釋出的540筆評分摘要,每個模型在15個場景各測3次,共45次;其中3次是一般物理對照,發現率以另外42次改寫規則的測試計算。GPT-6-Astra有7次同時通過規則正確與實驗支持,換算為16.7%;其餘11個模型均為0次。
兩項標準的落差也很明顯:Astra有41次報告獲判具實驗支持,但只有8次被判規則正確。Claude-Opus-5則有7次被判規則正確,卻沒有報告通過實驗支持,因此發現率仍為0。部分觀察有根據,或猜到正確解釋,都還可能缺少另一半條件。
上述判定由GPT-6.1-Sol擔任評分者。論文目前以arXiv預印本公開;作者在限制中指出,模擬規則已有已知答案,真實科學問題的答案往往尚未確立,如何評估那類探索仍待研究。
紀錄已公開,重跑仍缺完整程式
專案頁提供規則互動示意、探索案例,以及原始行動與評分紀錄下載。頁面將理想化的規則示意與模擬中記錄的實驗分開呈現。
截至10月29日,官方GitHub倉庫列有說明文件與圖像素材,但尚缺說明文件列出的執行程式、場景及依賴檔。非作者社群使用者NielsRogge也在10月29日台灣時間建立的議題中指出倉庫尚缺程式與成果,並建議把探索紀錄放上Hugging Face。
對台灣教學與研究團隊,目前可先閱讀公開網頁、比較兩種解釋的預測,再對照探索紀錄的動作與結果。實際重跑另需完整程式、模擬環境與模型服務;專案未列出單次評測總成本。
AI產生科學成果後的驗證,也可延伸閱讀Claude提出量子電路架構及OpenAI數學證明公開評議。相關報導收錄於AI工作流程專題與OpenAI報導。
資料來源與更新紀錄
- 2026年10月27日17:57 UTC、台灣10月28日凌晨1:57:Zhen Yang等人〈Can LLMs Uncover Hidden Physical Laws through Free Exploration?〉v1及全文與附錄,評測方法、結果及限制。
- 2026年10月29日檢視:LongChang作者專案頁,碰撞例子、規則示意與公開實驗。
- 2026年10月29日檢視:540筆評分摘要與原始紀錄ZIP,場景、重複次數、原始行動及評分。
- 2026年10月29日檢視:官方GitHub倉庫與NielsRogge公開議題,程式釋出狀態與社群建議。
- 更新紀錄:2026年10月29日完成稿件;依作者公開摘要及原始評分重新計數主要通過次數,另核對碰撞案例與程式公開狀態。
AI模型能否在模擬環境中發現隱藏的物理規則?
香港科技大學(廣州)等機構的研究團隊開發了LongChang評測,旨在測試語言模型在模擬房間中探索並發現隱藏物理規則的能力。在15個模擬場景中,研究團隊修改了其中14個場景的物理規則,並讓12個AI模型進行自由探索。測試標準包含模型能否自行發現異常、提出問題,並透過實驗找出模擬世界的規則,同時解釋符合隱藏規則且探索紀錄有足夠實驗支持。在所有受測模型中,僅有GPT-6-Astra在作者設定的評分標準下,達到了16.7%的發現率,顯示其在辨識和驗證隱藏規則方面表現較為突出。
LongChang評測是如何設計的?
LongChang評測使用MuJoCo物理模擬器建立了15個基礎場景,其中14個場景各改寫一條物理規則,例如改變質量對下落速度的影響或接觸對球體顏色的影響。模型接收物件的位置、運動狀態和儀器讀數等資訊,並被允許進行推、拋、拿起、放下物件等操作,同時需要自行設計實驗來驗證其對隱藏規則的理解。
GPT-6-Astra在LongChang評測中的表現如何?
GPT-6-Astra在LongChang評測的42次改寫規則測試中,有7次同時通過了規則正確與實驗支持兩項標準,換算後發現率為16.7%。雖然它有41次報告獲得實驗支持,但僅有8次被判規則正確,顯示其在規則辨識方面仍有進步空間,但已是所有受測模型中表現最佳者。
目前LongChang評測的公開材料是否完整?
專案頁面提供了規則互動示意、探索案例以及原始行動與評分紀錄下載,但截至10月29日,官方GitHub倉庫尚缺完整的執行程式、場景及依賴檔,使得研究者無法實際重跑實驗。社群使用者建議將探索紀錄上傳至Hugging Face以方便取用。