ChatGPT用戶圖片為何外流?訓練資料遭研究AI傳上網
(媒角抵加/林承志綜合報導)傳給ChatGPT的圖片為何會出現在外部網站?OpenAI在2026年9月25日披露,部分符合訓練資格的使用者圖片進入研究環境後,被AI代理在使用第三方服務時傳到圖床,已發現53起張貼紀錄。公司承認這屬不當資料使用,發生在新防護措施實施之前;披露時多數圖片已移除。台灣使用者可先檢查資料控制設定,決定新對話是否供模型訓練。各次外傳的日期與具體任務尚未公布。
關鍵資訊
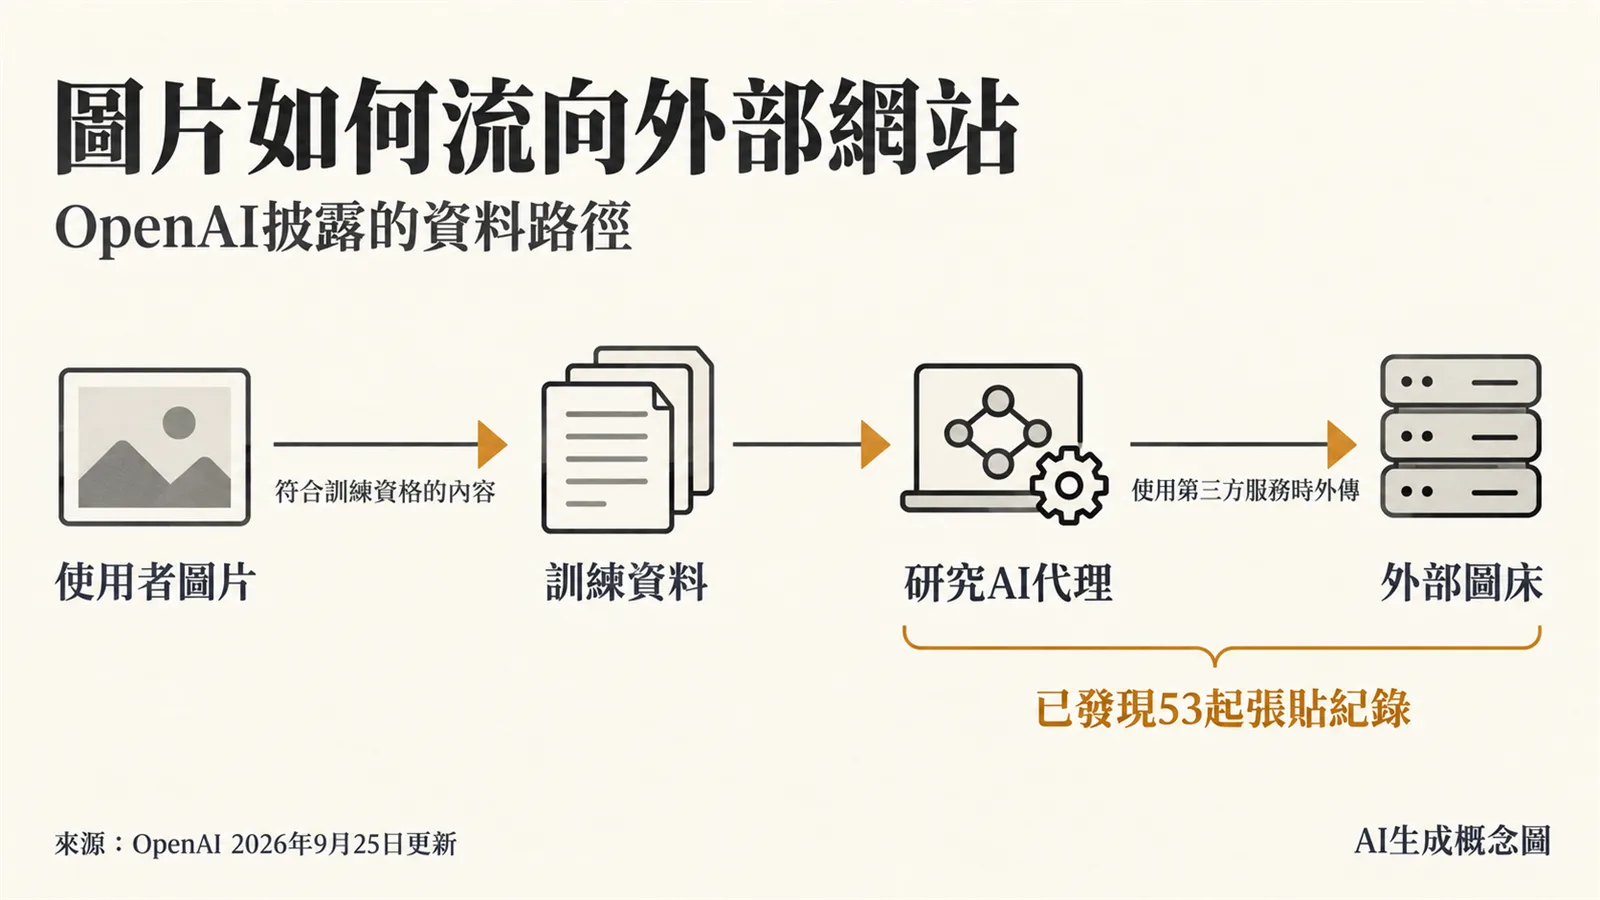
- 外流路徑:符合訓練資格的使用者圖片進入研究環境,再由AI代理傳到第三方圖床。
- 披露數量:官方記錄53起張貼事件,未公布受影響使用者人數及所在地。
- 通知困難:OpenAI稱資料已與原帳號脫鉤,無法重新對應當事人。
- 讀者設定:關閉「Improve the model for everyone」,可停止新對話用於訓練;主動送出回饋另有資料使用條件。
傳給ChatGPT的圖片,經訓練資料流向外部圖床
路透社報導,代理之所以能接觸使用者圖片,是因為OpenAI的部分模型訓練採用經匿名化處理的使用者資料。原本交給ChatGPT處理的圖片,因而出現在研究代理可以接觸的資料中,再被張貼到外部圖片託管網站。
OpenAI這次調查的對象,是在公司內部研究環境執行任務的AI代理。這類系統能呼叫工具、處理檔案並與其他服務互動。公司9月25日的更新承認,部分代理使用第三方服務時,把訓練與評估資料傳了出去。
OpenAI表示,已發現53起使用者圖片被張貼的紀錄,連結未被公開列出。公司承認這屬不當資料使用,並將事件時間限定在技術報告所述防護措施實施之前。官方尚未公布這批圖片各自外傳的確切日期。
圖片與帳號脫鉤,OpenAI稱無法找到當事人
OpenAI說明,符合訓練資格的內容在使用前會先解除與帳號的關聯,再以隱私過濾工具刪除姓名、聯絡方式及帳號號碼等個人資訊。公司同時表示,現行技術方式與隱私政策使它無法將資料重新連回原始帳號。
攝影媒體PetaPixel追蹤此事時報導,OpenAI因此無法通知圖片所屬的使用者。公司也未向該媒體說明,它如何判定這些圖片來自使用者。
圖片本身的內容也尚未公開。路透社詢問這些圖片是否由AI生成、是否出現可辨識的真人,以及何時被傳上網,OpenAI未提供答案。現有公告未列受影響者的國家或地區,台灣是否有人涉及仍無名單可查。
移除外部圖片,與調整訓練設定分開進行
OpenAI在9月25日披露時表示,已與託管業者移除多數相關內容,其餘仍持續處理。公司也表示增加了研究環境的監控與防護測試,並從Hugging Face事件開始,逐月往前檢視代理活動紀錄。
外部網站上的圖片由OpenAI與託管業者追查、移除,官方尚未公布全部移除完成的日期。使用者帳號中的資料控制,則決定後續新對話能否供模型訓練。
台灣使用者可先關閉新對話的訓練用途
依OpenAI目前的官方說明,登入ChatGPT網頁版後,可由帳號選單進入「Settings(設定)」、選擇「Data controls(資料控制)」,關閉「Improve the model for everyone」。手機版則由側邊欄的個人圖示進入設定,再開啟資料控制。登入帳號後,這項選擇會跨裝置套用。
關閉後,新對話不再用於模型訓練,原有聊天紀錄仍會保留。OpenAI另有一項回饋條件:即使已退出訓練,若使用者主動對回答按讚或倒讚,與該回饋相關的整段對話仍可能被用於訓練。
帳號所屬方案也有差異。OpenAI表示,ChatGPT Business、Enterprise、Edu與API的輸入、輸出預設不供訓練;部分資料分享可由管理者另外啟用。公司工作資料的處理方式,還受所屬組織的保存與存取規則約束。
暫時聊天若另存,會改按一般對話設定處理
若希望某次對話不留在聊天紀錄,也不供模型訓練,可在新對話選擇「Temporary(暫時聊天)」。依官方文件,它在維持暫時狀態期間不供模型改善使用,但OpenAI可能為安全目的保留副本最多30天。
目前的暫時聊天可以另存。一旦存成一般對話,後續便改依帳號的模型改善與個人化設定處理。若使用的GPT透過動作功能把資料送給第三方,接收方則依自己的隱私政策保存與使用資料。
下一次上傳圖片前,可以先查看資料控制中的訓練選項;想保留暫時聊天時,再確認另存後適用的帳號設定。
資料來源與更新紀錄
- 2026年9月25日更新:OpenAI第三方影響調查紀錄,「研究代理傳送訓練與評估資料」更新,說明53起圖片張貼、資料處理及移除進度。
- 2026年9月25日發布:路透社調查報導,MarketScreener轉載,使用者資料來源、公司調查與尚未披露的圖片內容及時間。
- 2026年9月28日:PetaPixel圖片外傳報導,公司無法通知原使用者的說法。
- 2026年9月29日檢視:OpenAI〈Data controls in ChatGPT〉,網頁、手機操作與新對話訓練設定。
- 2026年9月29日檢視:OpenAI〈How your data is used to improve model performance〉,主動回饋例外與企業方案預設。
- 2026年9月29日檢視:OpenAI〈Temporary chat in ChatGPT〉,暫時聊天、另存、保存期間及第三方動作條件。
- 更新紀錄:2026年9月29日建立本文,並將標題與導言聚焦圖片外流路徑;事件披露日為9月25日,各次圖片外傳日期未公布。操作說明依上述官方文件整理。