ChatGPT文字浮水印將上路,老師與編輯能驗出什麼?
OpenAI 如何在 ChatGPT 中加入文字浮水印以辨識 AI 生成內容?
OpenAI 將在未來數週內,於歐盟地區符合資格的 ChatGPT 與 Codex 文字輸出中加入看不見的浮水印,並開放全球 API 客戶為支援模型選擇啟用此功能。此技術稱為 textGrain,透過調整選詞機率來形成可由偵測器分析的統計訊號,以協助辨識文字是否由 OpenAI 模型生成或處理。然而,此浮水印無法顯示作者身分或人工修改比例,且改寫或短文可能降低偵測能力,偵測器目前僅供核准的研究者與機構使用。
(媒角抵加/林承志綜合報導)OpenAI於2026年10月5日宣布,未來數週將在歐盟符合資格的ChatGPT與Codex文字輸出加入看不見的浮水印,全球API客戶可為支援模型選擇啟用。訊號可協助辨識文字是否經OpenAI模型生成或處理,卻不顯示作者身分或人工修改比例。目前偵測器僅供核准研究者與機構使用;台灣一般使用者尚無官方文字驗證入口,也未列入這次預設導入範圍。
關鍵資訊
- 導入安排:歐盟符合資格的ChatGPT與Codex用戶,涵蓋各方案,未來數週分階段導入。
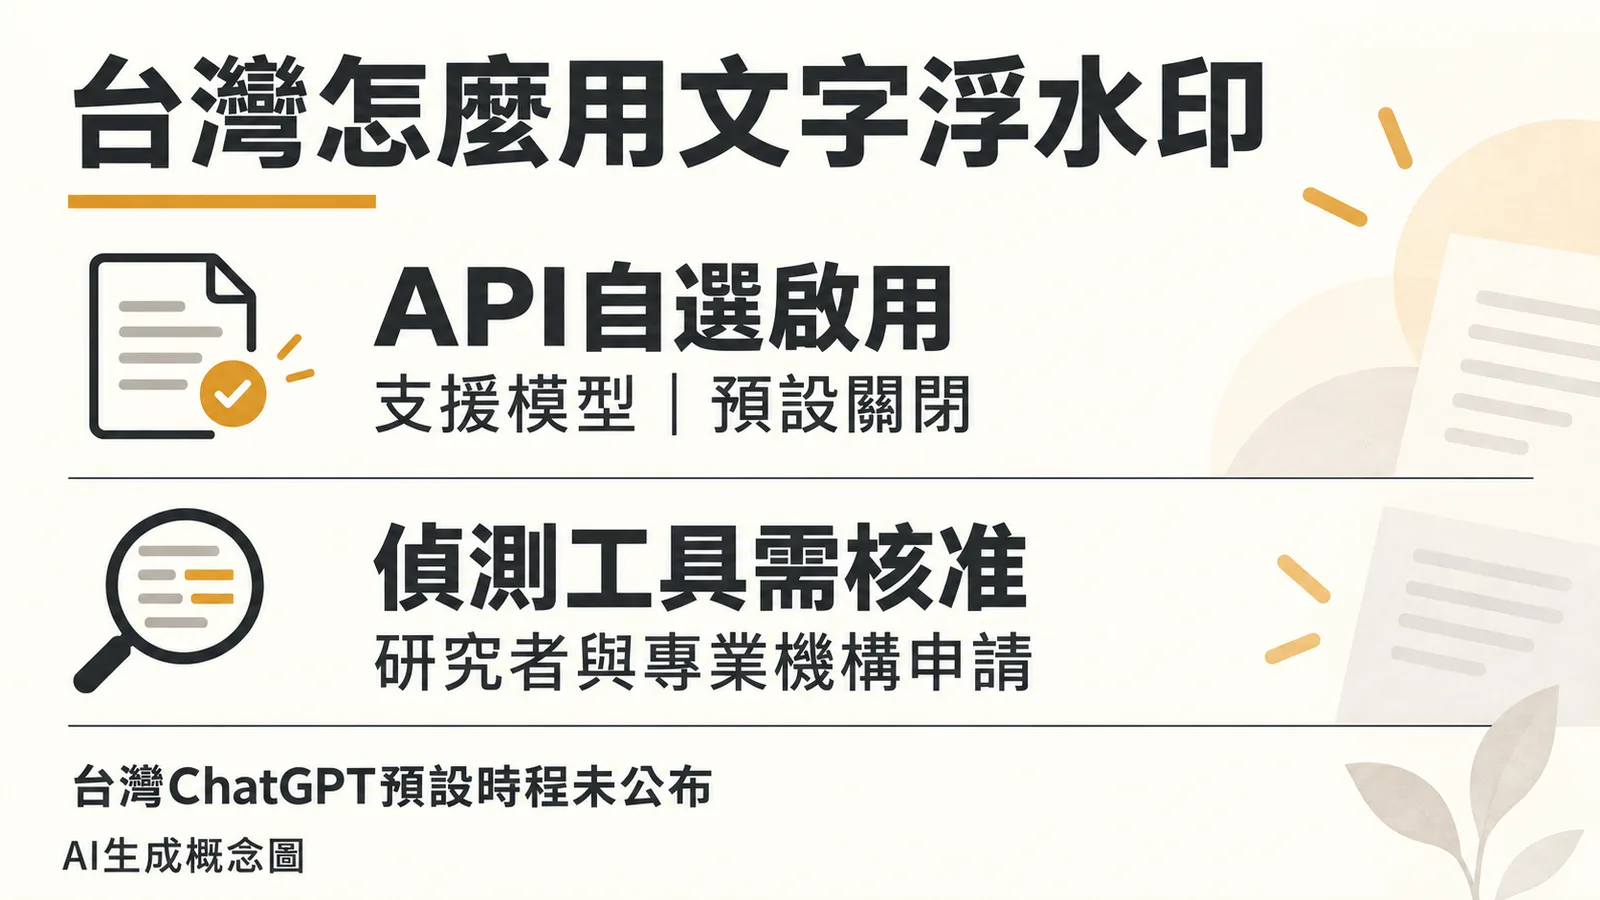
- 台灣可用範圍:API在官方支援地區名單內,可為支援模型自選啟用;台灣ChatGPT預設時程未公布。
- 文字偵測門檻:研究者與專業機構申請、經OpenAI核准後取得工具;啟用浮水印不附帶偵測權限。
- 人工判斷:作業或投稿的AI使用規則、作者貢獻與內容正確性,仍由收件單位及作者分別確認。
歐盟帳號先導入,台灣API可自行選擇
OpenAI表示,此次安排回應歐盟《AI法》的文字出處要求。依歐盟執委會透明度規範說明,生成式AI服務提供者的機器可讀標記,與使用者對特定公開內容的揭露,是分別處理的義務;相關實務守則提供自願採用的遵循框架。
對台灣讀者而言,兩個入口的安排不同:ChatGPT與Codex這次的預設文字浮水印限歐盟;API則從10月5日起讓全球客戶為選定模型自選啟用,預設保持關閉。OpenAI API支援地區名單列有台灣。
依OpenAI設定說明,開發者可在組織的「Data controls → Text provenance」,或個別專案的「Text provenance」中,開啟「Allow text watermarking」、選擇模型並儲存。支援型號以設定頁當下列出的清單為準。
浮水印留在選詞中,複製貼上仍可能保留
這套技術稱為textGrain。依10月5日公開的技術報告,模型在逐步生成文字時,透過與祕密金鑰相關的規則調整選詞機率,形成可由偵測器分析的統計訊號。讀者看到的是普通文字,標記藏在一段話的選詞分布裡。
OpenAI的產品說明指出,浮水印沒有加入隱藏字元、空白或額外標記。保留原措辭的複製貼上,預期仍能保留訊號;偵測是否成功,還與文字長度及可供選擇的措辭有關。
英文內測顯示,改寫與短文會降低偵測能力
OpenAI在官方評估中,以400個token的英文回答測試改寫影響:原本約92%的浮水印可被偵測,將10%的詞換成同義詞後降至66%,替換25%後降至17%。Token是模型處理文字的單位,可能是一個詞或詞的一部分,與中文字數不同。
短回答、數學與程式碼也較難形成足夠訊號。OpenAI說明,翻譯或大量改寫可能削弱浮水印;沒有驗出訊號的文字,也可能來自未支援模型、其他公司的工具,或浮水印導入前的輸出。偵測結果提供的是特定模型參與的線索。
作業與投稿,先把允許使用AI的步驟寫清楚
OpenAI列明,浮水印不衡量人類貢獻、不確認內容真偽,也不顯示使用者、帳號或提示內容。老師或編輯即使取得偵測結果,仍會面對另一個問題:這份作業或稿件允許AI參與哪些步驟?作者做了哪些修改與查核?
台灣已有可供對照的校內指引。成大戲劇碩士學程公布的校內生成式AI說明列明,使用者揭露工具名稱、使用方式與日期,最終學術責任由使用者承擔;臺大研究誠信辦公室則說明,各單位可依學門特性、研究型態與風險訂定細部規範。這些規則各有適用對象,學生交件前可先確認課程要求。
收作業或投稿時,可把允許的AI步驟與交件紀錄一起寫進說明:工具用於提綱、校對還是段落生成;作者保留初稿、引用來源,以及人工修改的部分。有疑問時,請作者說明一段文字如何形成,或解釋其中的資料與推理。本站的AI作業分級報導整理了按任務訂規則的做法;要了解學生是否真正理解,也可參考離開AI後獨立作答的觀察方式。
台灣開發者先核對繁中輸出,再決定驗文流程
OpenAI公開的語言圖表測試歐盟24種官方語言,未列繁體中文。台灣團隊若要在內容服務加入浮水印,可先確認支援模型與設定權限,再比較開啟前後的繁中輸出:引用、措辭與內容品質是否符合原有驗收條件。這一步檢查的是文字交付品質。
偵測效果則有另一道門檻。OpenAI申請規則將文字偵測工具限於核准的研究與專業機構,啟用浮水印不等於取得偵測權限;公開的驗證網站目前處理支援的圖片與音訊。OpenAI把誤判與漏驗風險列為限制初期開放的原因,這次公告未列一般消費者驗文方案或價格。
對目前收作業、投稿或委外文案的台灣讀者,今天可先建立的流程是:交件前約定AI使用範圍,交件時留下使用與修改紀錄,收件後核對來源及作者的說明。對準備啟用浮水印的服務團隊,則先從支援模型與非機密測試稿開始,分別確認輸出品質及偵測資格。相關工具與做法可由AI工作流程與OpenAI主題頁查閱。
資料來源與更新紀錄
- OpenAI:歐盟文字出處規則與導入安排,2026年10月5日公布;本文的時程、地區與英文內測數據來源。
- OpenAI:生成內容的出處訊號與操作說明,2026年10月6日查閱;設定方式、偵測資格、語言圖表及訊號限制。
- textGrain技術報告,2026年10月5日;生成與偵測的統計機制。
- OpenAI API支援地區,2026年10月6日查閱;台灣列名。
- 歐盟執委會:AI生成內容透明度實務守則,頁面標示2026年7月31日更新;2026年10月6日查閱。
- TNW:OpenAI歐盟文字浮水印報導,Ana Maria Constantin,2026年10月5日;公告時點與地區安排補充。
- 成大生成式AI學術誠信說明,2026年7月27日更新;臺大生成式AI使用與研究誠信指引公告,均於2026年10月6日查閱。
- 更新紀錄:2026年10月6日整理文字浮水印導入、台灣API條件、偵測限制與作業/投稿紀錄做法。
- 圖片紀錄:2026年10月6日加入AI生成的紙稿審閱主圖與台灣啟用/偵測條件配圖,均為示意用途。
文字浮水印技術 textGrain 是如何運作的?
textGrain 技術在模型逐步生成文字時,會透過與祕密金鑰相關的規則來調整選詞機率,進而形成可供偵測器分析的統計訊號。一般使用者看到的仍是普通文字,標記隱藏在選詞的分布中,且不加入額外字元或標記。
改寫或翻譯會影響文字浮水印的偵測嗎?
是的,英文內測顯示,改寫或翻譯可能削弱浮水印的偵測能力。將部分詞替換成同義詞會顯著降低偵測率,短回答、數學內容或程式碼也較難形成足夠的訊號。
台灣使用者何時能使用 ChatGPT 的文字浮水印功能?
目前 ChatGPT 的預設文字浮水印僅限歐盟地區,台灣的預設導入時程尚未公布。不過,台灣的 API 客戶可從 10 月 5 日起,為官方支援地區名單內的選定模型自選啟用文字浮水印功能。