Meta刪改網站爬取條款,稱僅限廣告與商務產品
Meta修改網站爬取條款,移除訓練用途的說明是什麼原因?
Meta於10月17日向The Verge表示,已刪改引發爭議的網站爬取條款,並澄清相關條款僅適用於廣告與商務產品,爬蟲作法並未改變。公司發言人Daniel Roberts指出,此次更新釐清了條款的適用範圍,並未賦予Meta凌駕於網站內容擁有者存取偏好之上的新權利。先前爭議源於條款中曾涵蓋訓練用途的內容,但Meta稱此舉是為了整併條款,並未取得新的權利。
(媒角抵加/林承志綜合報導)Meta刪改引發出版界爭議的網站爬取條款。發言人Daniel Roberts於10月17日向The Verge表示,相關條款只適用廣告與商務產品,爬蟲作法未變,內容擁有者仍可用robots.txt表達存取偏好。該報指出,涵蓋訓練用途的一整句已移除;這份回覆未列台灣版本、生效日期或個別帳號的授權範圍。
關鍵資訊
- 刪改內容:The Verge指出,商務條款移除一整句內容用途說明,其中原本列有訓練用途。
- 公司回應:Meta稱此次整併限廣告與商務產品,沒有取得凌駕網站存取偏好的新權利。
- 涉及對象:爭議涉及商務帳號及其關聯網站,出版者關切站外內容的使用範圍。
- 台灣確認點:帳號收到的版本、生效日期、契約主體,以及條款涵蓋哪些網站與內容。
刪去訓練用途句子,Meta稱爬蟲作法未變
依The Verge的10月17日報導,被移除的整句原本列出Meta使用關聯網站內容的多種目的,包括研究及訓練。Roberts向該報表示,公司已在條款中釐清廣告與商務產品的適用範圍,這次更新並未改變網站爬取方式,也未賦予Meta超越內容擁有者存取偏好的新權利。
出版者關切商務帳號與站外內容連動
爭議起於修改前的文字。Nieman Lab於10月15日刊出的條款節錄與採訪顯示,授權文字涵蓋與商務產品或服務相關聯的網域、網頁及網址。康乃爾大學法學院教授James Grimmelmann針對這份文字受訪時認為,廣泛解讀可能容許Meta把出版者網站內容用於AI訓練。
《The Steampunk Explorer》創辦人兼編輯Stephen Beale告訴Nieman Lab,他在Meta Business Suite後台看到更新通知。他長期靠Facebook接觸讀者、導流至自己的網站,站外內容授權因此牽動既有的讀者經營方式。
美國出版業組織News/Media Alliance也在10月16日公開的聲明摘要中批評這次商務條款變更。
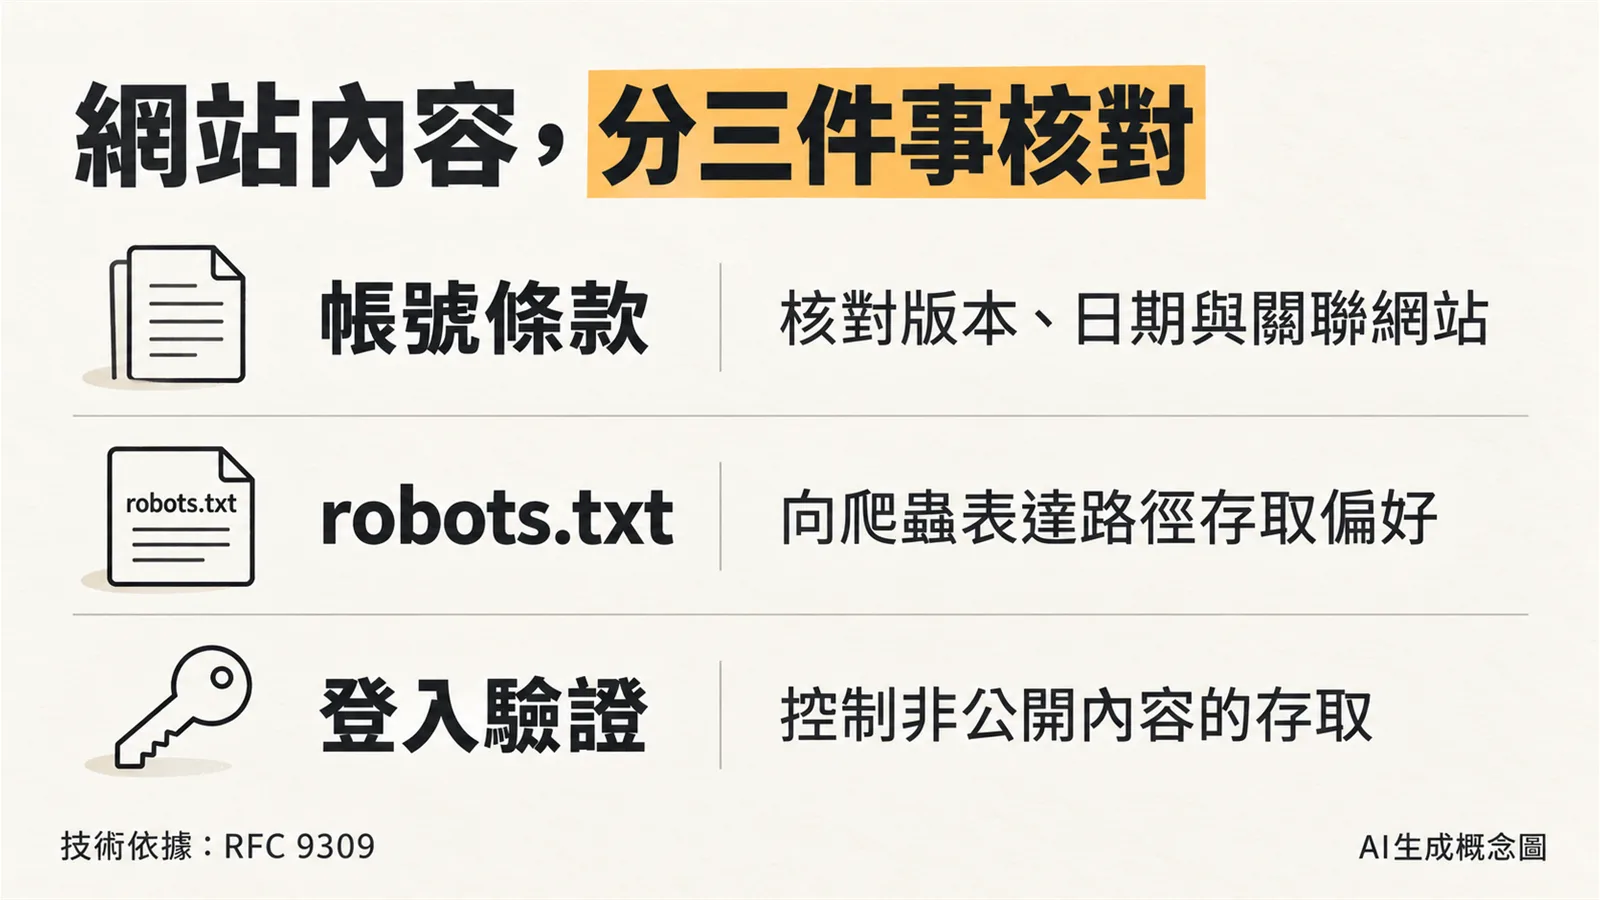
robots.txt傳達爬取偏好,非公開內容另靠驗證
Meta回覆中提到的robots.txt,是網站放在根目錄、供爬蟲讀取規則的檔案。依IETF的RFC 9309,網站可以按爬蟲識別名稱及網址路徑,列出允許或不允許爬取的範圍。
這套協定依靠爬蟲遵循規則。RFC明載,這些規則不是存取授權機制,也不能取代網站安全措施;需要保護的非公開內容,另以登入驗證等方式控制存取。網站管理者可把爬蟲規則、實際存取紀錄與內容保護設定一起核對。
台灣業者先整理帳號通知與關聯網站
Roberts這次公開回覆沒有另列台灣商務帳號的條款版本、契約主體及生效日期。對經營粉專、廣告與自有網站的台灣團隊,具體的起點是保存帳號通知與所連結的條款,記下版本和日期,再列出帳號綁定的網域,以及站內自製、授權或會員內容。
這份清單可交由帳號負責人、網站管理者與法務共同確認:誰能代表團隊接受條款、哪些內容有權對外授權,以及網站存取設定是否符合經營需求。涉及第三方授權素材或會員內容時,逐項核對原有契約,才能判斷個別內容的使用範圍。
相關權限問題可延伸閱讀本站的ChatGPT讀取Chrome分頁前如何授權與AI代理上工前先問四件事;更多議題收錄於AI安全專題。
資料來源與更新紀錄
- The Verge:Meta removes language that may have allowed it to scrape news sites,Terrence O’Brien,2026年10月17日;條款刪改觀察及Daniel Roberts具名回覆。
- Nieman Lab:Meta’s new commercial terms will allow the scraping of news sites, legal experts say,Andrew Deck、Hanaa’ Tameez,2026年10月15日;修改前文字、專家及出版者採訪。
- News/Media Alliance:AI-A公開分類頁,2026年10月16日聲明摘要。
- RFC Editor:RFC 9309 — Robots Exclusion Protocol,2022年9月;爬蟲規則與安全措施的技術定義。
- Meta公司資料,公司背景。
- 更新紀錄:2026年10月18日完成初稿;條款變動與公司回應依上述日期標示,台灣個別帳號適用內容依帳號通知及契約文件確認。
Meta修改網站爬取條款的爭議點是什麼?
爭議點在於Meta修改的商務條款中,移除了原本列有「訓練用途」的內容,出版界擔心這可能允許Meta將其網站內容用於AI訓練。雖然Meta聲稱爬蟲作法未變,但移除此句引發了對內容使用範圍的疑慮。
robots.txt在網站爬取中扮演什麼角色?
robots.txt是一個網站根目錄下的檔案,用於告知搜尋引擎爬蟲哪些內容可以爬取,哪些不可以。然而,它僅是傳達爬取偏好,並非存取授權機制,也不能取代網站的安全措施。
台灣業者在面對Meta條款修改時應如何處理?
台灣業者應保存收到的帳號通知與所連結的條款版本、生效日期,並列出帳號綁定的網域及內容。接著由帳號負責人、網站管理者與法務共同確認授權範圍與存取設定是否符合經營需求。