Uber將ChatGPT Work推向逾3萬員工,從千人試點擴大
(媒角抵加/林承志綜合報導)Uber把AI工作代理從千人試點擴大到全球辦公室。OpenAI10月22日宣布,ChatGPT Work將在Uber的企業帳號內開放給逾3萬名員工,用來串接工作資料、整理分析並製作文件。Uber同時準備技能庫、核准整合與員工訓練;台灣團隊若評估導入,可先核對資料權限與交付成果的人工驗收方式。
關鍵資訊
- 部署範圍:Uber由1,000人試點,擴大全球逾3萬名員工的使用權限。
- 企業環境:透過ChatGPT Enterprise提供ChatGPT Work。
- 辦公用途:研究資料、準備會議、分析數據與製作簡報等多步驟任務。
- 導入配套:公司核准的工具整合、內部AI技能庫與員工訓練。
- 人機分工:代理整理資料與產出檔案,人員檢查結果;重要動作受工作區及應用程式權限控管。
- 目前狀態:企業擴大部署已宣布,採用情況與可量測成果將隨推行進度分享。
從千人試點擴大,辦公任務成為使用重點
Uber工程副總Sumanth Sukumar接受TechCrunch採訪時表示,試點參與者約八成為非工程師,任務包括營運資料分析、教材在地化與個人化儀表板。
依OpenAI公告,這次擴大部署涵蓋營運、財務、行銷及產品等部門,工具可連接Google Drive、Gmail、Google Calendar與Slack。Uber的推行方式也包含內部技能庫與專門訓練,讓不同職務能沿用核准的工具與做法。
從散落的資料,做到可檢查的工作檔案
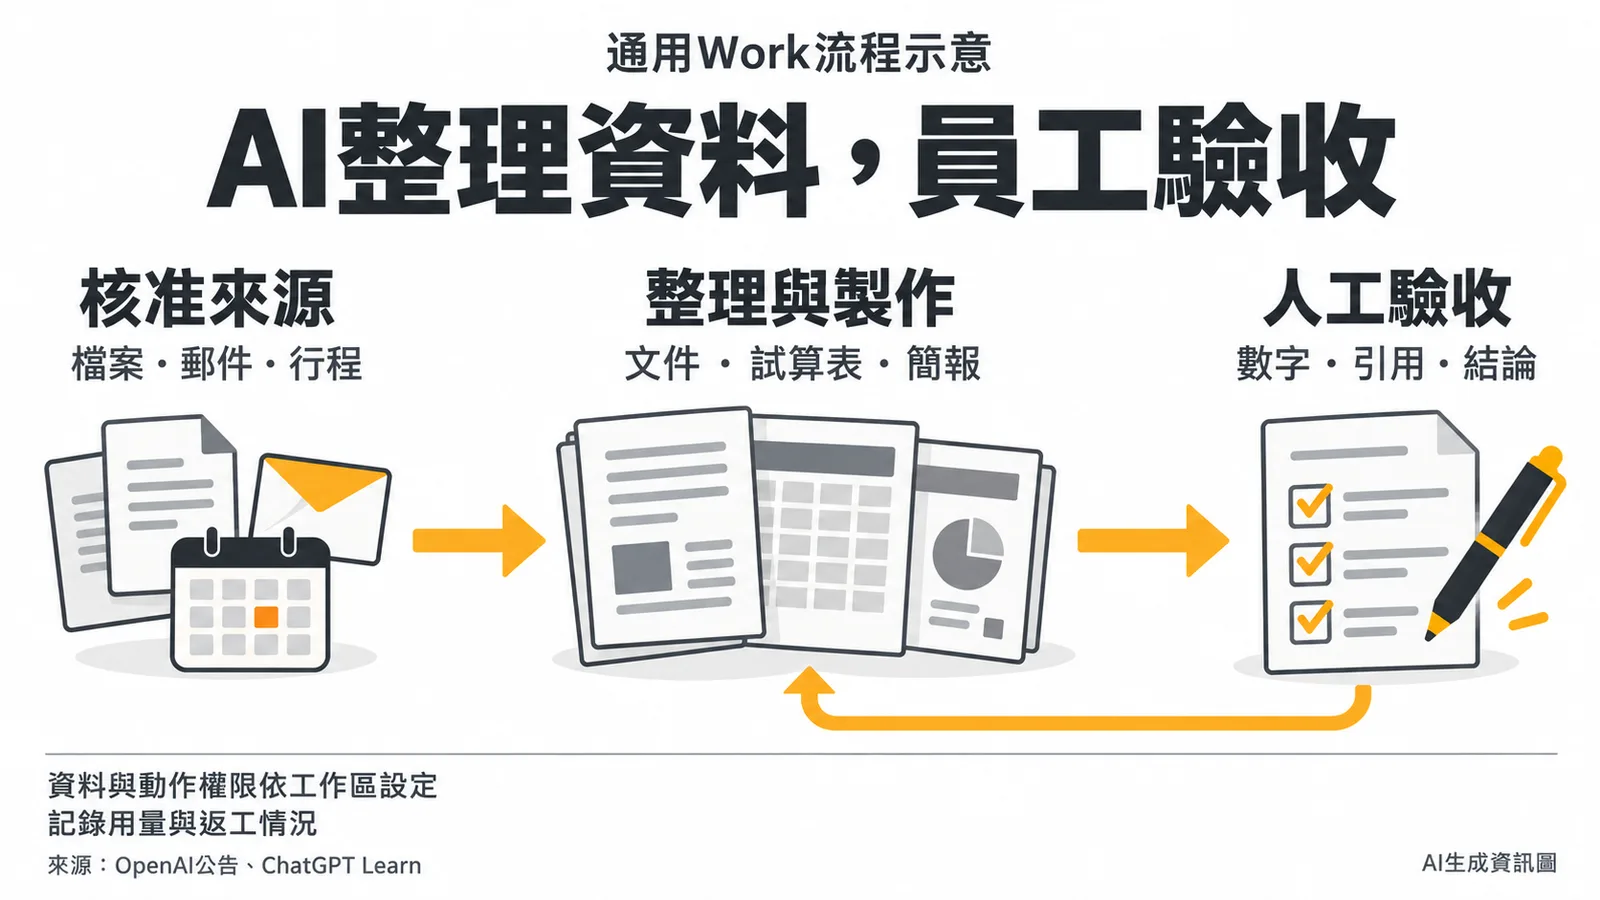
OpenAI的Work入門文件將這類代理定位為執行較長、多步驟任務的工具:員工提供目的、來源與限制,代理取用獲准的檔案或外掛,整理資訊並交回文件、試算表或簡報。執行中,使用者可查看進度、補充資料與調整方向。
官方入門文件也建議,交辦時寫明成果格式、可用來源與接受檢查的時點。例如製作會議簡報,驗收可逐項核對數字、引用與結論,再決定是否使用或交回修正。
讀取資料與執行動作,由企業分別控管
資料串接的範圍取決於公司設定。OpenAI企業Work文件說明,工作區管理者可管理外掛與應用程式的開放對象、連接帳號及動作權限;支援的整合可限制為唯讀,或只允許核准的操作。共用帳號連接使用的是該帳號在原系統的權限,可能與提出任務的員工不同。
同一份文件也指出,各應用程式的動作控制不同,部分動作不會逐次要求使用者確認。企業安排人員驗收時,除了看產出的文件,也要確認代理所用帳號能讀取哪些資料、能修改哪些內容。對工作網頁的讀取授權,亦可參考本站ChatGPT Chrome分頁協作報導所整理的操作情境。
擴大之後,用量與交付品質一起計算
Uber與OpenAI在公告中表示,會隨部署進度分享採用情況、案例與可量測成果。此次公告未列出擴大後的活躍使用率、節省工時或企業合約金額。
對評估採用的公司,OpenAI的企業Work用量文件說明,適用點數合約的任務會消耗工作區共用額度,實際消耗受模型、任務複雜度與執行頻率影響;是否增加帳單費用,還取決於剩餘額度、合約費率及超額設定。管理者可使用支援的個人用量上限與工作區超額上限,通知警示本身不會停止支出。
該文件建議,同一工作流程導入前後,並列完成時間、成果品質、返工或錯誤情況,再與用量及實際帳單比較。
台灣團隊可先選一份能驗收的工作
此次Uber公告以全球員工為範圍,沒有分列台灣辦公室的開放人數或時程。其他企業能使用哪些功能,則依自己的方案與工作區設定決定;OpenAI管理者FAQ也把存取權限、來源資料與使用額度列為導入時的管理項目。
台灣團隊可先選一項有既有資料、固定交付格式與負責人的工作,例如每週營運會議簡報:圈定可讀來源,交回附引用的檔案,由業務負責人核對,再記錄完成時間、修正次數與用量。
資料來源與更新紀錄
- OpenAI:Uber brings ChatGPT Work to all employees with OpenAI,2026年10月22日;部署範圍、工具串接、訓練與後續成果計畫。
- TechCrunch:Uber puts all 30,000 employees on ChatGPT Work,Lucas Ropek採訪Uber工程副總Sumanth Sukumar,2026年10月22日09時PDT刊出,台北時間10月23日0時。
- ChatGPT Learn:Get started with ChatGPT Work,2026年10月23日查閱;任務交辦、工具與成果檢視。
- ChatGPT Learn:ChatGPT Work Overview,2026年10月23日查閱;企業資料連接、帳號與動作權限。
- ChatGPT Learn:ChatGPT Work usage and cost,2026年10月23日查閱;額度、費用控制與成果量測。
- ChatGPT Learn:ChatGPT Work admin FAQ,2026年10月23日查閱;工作區管理與導入條件。
- 相關主題:AI工作流;企業與產品資料:OpenAI。
- 延伸閱讀:Claude Duet背景工作報導,了解另一項代理產品整理郵件、行程與準備工作的方式,以及重要動作的核准條件。
- 更新紀錄:2026年10月23日完成新聞稿。
Uber如何擴大使用ChatGPT Work於全球員工?
Uber已將ChatGPT Work的試點計畫擴展至全球超過3萬名員工,透過ChatGPT Enterprise提供此項服務,旨在串接工作資料、整理分析並製作文件。此工具可協助處理營運資料分析、教材在地化、準備會議、分析數據與製作簡報等多步驟任務,並支援與Google Drive、Gmail、Google Calendar及Slack等應用程式的整合。Uber為此配套導入了公司核准的工具整合、內部AI技能庫與員工訓練,並強調人機分工,由AI代理整理資料與產出檔案,再由人員檢查結果,重要動作則受工作區及應用程式權限控管。
ChatGPT Work在Uber的辦公用途有哪些?
ChatGPT Work在Uber的辦公用途廣泛,包括研究資料、準備會議、分析數據、製作簡報、營運資料分析、教材在地化與個人化儀表板等。它能協助員工處理較長、多步驟的任務,從散落的資料中整理出可供檢查的工作檔案。
Uber如何確保AI代理的安全與準確性?
Uber透過多重機制確保AI代理的安全與準確性。工作區管理者可管理外掛與應用程式的開放對象、連接帳號及動作權限,支援的整合可限制為唯讀或僅允許核准的操作。此外,Uber強調人機分工,由員工檢查AI產出的文件、數字、引用與結論,並依據工作區設定控管資料與動作權限。